

Techniques d’ajustement perfectionnées.
1. Choisir le bon algorithme de minimisation
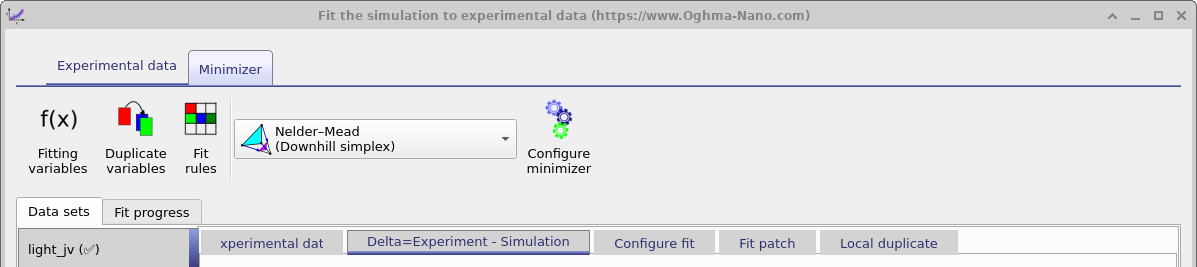
La barre d’outils « Minimizer » est l’endroit où vous sélectionnez et configurez l’algorithme qui contrôle le processus d’ajustement. Le choix du bon algorithme de minimisation peut faire la différence entre une convergence rapide et stable et un ajustement lent ou instable. OghmaNano propose plusieurs algorithmes bien établis, chacun ayant des avantages différents, et qui peuvent être sélectionnés dans le menu déroulant « Méthode d’ajustement ».
De manière générale, les algorithmes d’ajustement se répartissent en deux catégories. La première comprend les méthodes de descente de gradient, qui tentent de « faire rouler une balle sur une pente » jusqu’à ce qu’elle atteigne l’erreur minimale. Certaines de ces méthodes nécessitent le calcul explicite du gradient, ce qui peut être coûteux et problématique pour les modèles complexes ; d’autres sont indépendantes du gradient et sont généralement plus robustes. La deuxième catégorie comprend les méthodes statistiques, qui ne se contentent pas de rechercher l’ajustement optimal, mais fournissent également une distribution de probabilité qui indique le degré de confiance et l’unicité de la solution. Ces méthodes sont plus exigeantes en termes de calcul, mais elles peuvent fournir des informations plus approfondies sur l’incertitude des paramètres.
| Méthode | Descente | Dégradé | Statistique | Commentaire |
|---|---|---|---|---|
| Méthode de Nelder-Mead | ✅ | ❌ | ❌ | Solide, lent, fiable. |
| Newton | ✅ | ✅ | ❌ | Fragile, parfois rapide. |
| Recuit thermique | ❌ | ❌ | ✅ | Étonnamment bon. |
| Chaîne de Markov Monte Carlo | ❌ | ❌ | ✅ | ? |
| HMC | ❌ | ❌ | ✅ | ? |
Méthode de Nelder-Mead (méthode du simplexe)
L’algorithme Nelder-Mead, qui utilise la méthode du simplexe, est la méthode d’optimisation la plus utilisée dans OghmaNano ; en fait, toutes les publications parues jusqu’en 2024 s’y sont appuyées. Une présentation générale de cette méthode est disponible ici : https://en.wikipedia.org/wiki/Nelder%E2%80%93Mead_method. En pratique, cet algorithme de minimisation est robuste et ne nécessite pas de calcul de gradients, ce qui le rend particulièrement adapté aux problèmes complexes. Ses principales options de configuration sont les suivantes :
- Nombre maximal d’itérations : interrompt le processus d’optimisation si l’erreur ne diminue pas après le nombre d’itérations spécifié.
- Désactiver la réinitialisation au niveau : empêche l’algorithme de redémarrer une fois que l’erreur est inférieure au seuil défini.
- Convergence acceptable : définit le seuil d’erreur à partir duquel on considère que l’ajustement a convergé et que l’exécution peut s’arrêter.
- Multiplicateur de l’étape initiale de l’algorithme simplex : définit l’ampleur de la perturbation initiale des paramètres. Les valeurs supérieures à 1,0 favorisent une exploration plus large de l’espace des paramètres ; les valeurs inférieures à 1,0 maintiennent l’ajustement proche de la valeur initiale. En règle générale, 2,0 est considéré comme une valeur « élevée » et 0,1 comme une valeur « faible ».
- Activer la prise d’instantanés pendant l’ajustement : par défaut, la prise d’instantanés est désactivée afin de réduire le nombre d’accès au disque. En activant cette option, vous forcez la sauvegarde d’un instantané à chaque étape, mais cela ralentit les performances.
- Étapes de réinitialisation du simplexe : indique le nombre d’étapes effectuées avant la réinitialisation du simplexe. La réinitialisation peut aider à sortir des minima locaux, mais elle peut également éloigner la solution de la convergence.
L’avantage principal de l’algorithme de Nelder–Mead réside dans sa simplicité et sa robustesse. Sur le plan conceptuel, il « fait rouler une boule en pente descendante » vers la zone où l’erreur est minimale, sans nécessiter de calculs de gradient, ce qui est particulièrement utile pour les modèles bruyants ou discontinus.
💡 Conseils pratiques pour utiliser l’algorithme de Nelder–Mead.
- Nous recommandons de commencer par l’algorithme de Nelder-Mead pour la plupart des problèmes d’optimisation. N’utilisez d’autres méthodes d’optimisation que si la convergence échoue ou si vous avez besoin d’informations statistiques.
- Cette méthode a été utilisée dans toutes les publications d’OghmaNano jusqu’en 2024, ce qui en fait une méthode éprouvée et fiable, servant de référence pour garantir la reproductibilité des résultats.
- L’algorithme de Nelder-Mead peut être lent pour les problèmes de grande dimension (c’est-à-dire lorsqu’il faut ajuster simultanément un grand nombre de variables).
- Il faut toujours limiter au minimum le nombre de variables à ajuster, en ne conservant que celles qui sont strictement nécessaires. Cela permet de réduire la dimensionnalité et d’améliorer la convergence.
- Effectuez d’abord une première itération pour vérifier la sensibilité des paramètres avant de lancer l’optimisation complète automatisée.
Recuit thermique
Le recuit thermique est une méthode d’optimisation stochastique inspirée du processus physique consistant à refroidir un matériau, en partant d’une température élevée pour atteindre une température basse. Dans OghmaNano, cet algorithme explore l’espace des paramètres défini par les limites de variables que vous spécifiez. Il est essentiel de définir correctement ces limites, car l’algorithme de minimisation ne recherchera pas de solutions en dehors de ces limites.
Dans la pratique, le recuit thermique donne souvent des résultats étonnamment bons et peut être plus rapide que l’algorithme de Nelder–Mead pour trouver une solution acceptable. Cependant, les résultats finaux sont parfois moins précis ou moins « affinés », et un ajustement supplémentaire avec l’algorithme de Nelder–Mead peut encore être nécessaire. Le recuit thermique est particulièrement utile pour sortir des minima locaux et effectuer une exploration globale de l’espace des paramètres.
- Enregistrer l’état actuel sur le disque à chaque intervalle de « n » étapes.
- Constante de refroidissement : elle détermine la vitesse à laquelle la « température » simulée diminue. Le refroidissement suit la formule \( e^{-k(T_{\text{start}}-T_{\text{stop}})} \), où \(T_{\text{start}} = 300\,K\) et \(T_{\text{stop}} = 0\,K\).
- Étapes de recuit : nombre d’itérations utilisées pour refroidir le système, en partant de \(T_{\text{start}}\) pour atteindre \(T_{\text{stop}}\).
💡 Conseils pour l’utilisation du recuit thermique.
- Il est préférable de l’utiliser lorsque l’algorithme de Nelder-Mead se bloque dans un minimum local.
- Définissez les limites des paramètres avec soin, car l’algorithme ne recherchera pas en dehors de ces limites.
- Attendez-vous à une convergence plus rapide que celle de l’algorithme de Nelder–Mead, mais avec des résultats finaux moins précis.
- Envisagez d’utiliser l’algorithme de Nelder–Mead par la suite afin d’affiner la solution obtenue par recuit simulé.
Newton
La méthode de Newton est incluse dans OghmaNano pour assurer une couverture complète, mais elle n’est que rarement le meilleur choix pour la plupart des problèmes d’ajustement. En tant que méthode de minimisation basée sur le gradient, elle exige que les dérivées soient calculées à chaque étape. Bien que cela puisse parfois la rendre plus rapide que la méthode de Nelder-Mead pour certains problèmes bien définis et à comportement régulier, cela rend également l’algorithme fragile : de petites erreurs numériques dans le calcul des dérivées peuvent entraîner une divergence ou un blocage de l’ajustement.
Dans la pratique, la méthode de Newton est très sensible à la valeur initiale et à l’échelle des variables. Sauf si le problème est très simple et bien défini, la convergence est souvent médiocre. Pour ces raisons, il n’est généralement pas recommandé de l’utiliser comme méthode principale, mais il peut s’avérer utile comme outil de diagnostic ou pour des expérimentations dans des cas contrôlés.
💡 Conseils pour utiliser la méthode de Newton.
- N’utilisez la méthode de Newton que pour résoudre des problèmes simples et bien définis, pour lesquels vous disposez de bonnes estimations initiales.
- Veillez à ce que les échelles des plages de valeurs variables soient bien définies, car une mauvaise définition de ces échelles peut entraîner une divergence.
- Si l’algorithme de Newton ne parvient pas à converger, utilisez l’algorithme de Nelder–Mead ou la méthode de recuit simulé.
- Il est préférable d’utiliser Newton principalement pour des tests ou pour explorer des cas spécifiques, et non pour l’optimisation en vue d’une production à grande échelle.
Chaîne de Markov Monte Carlo (CMMC)
La méthode de Monte Carlo par chaînes de Markov (MCMC) est une méthode statistique d’ajustement qui échantillonne l’espace des paramètres de manière aléatoire, mais d’une manière qui permet de construire progressivement la distribution de probabilité correcte au fil du temps. Contrairement aux méthodes de Nelder-Mead ou de Newton, qui renvoient un seul ensemble de paramètres constituant la « meilleure solution », la méthode MCMC produit une distribution de solutions qui indique la probabilité de différentes valeurs de paramètres. Cela la rend particulièrement efficace pour quantifier l’incertitude et identifier les corrélations entre les variables. Dans OghmaNano, cette fonctionnalité est implémentée, mais elle n’a pas été suffisamment testée.
Méthode de Monte Carlo hamiltonienne
La méthode de Monte Carlo hamiltonienne (HMC) étend le concept de la méthode de Monte Carlo par chaînes de Markov (MCMC) en utilisant les informations sur le gradient pour proposer des déplacements plus efficaces dans l’espace des paramètres. Au lieu de se déplacer de manière aléatoire, la HMC simule le « mouvement » d’une particule dans l’espace des probabilités, guidé par les gradients, ce qui peut améliorer considérablement l’efficacité de l’échantillonnage dans les problèmes de grande dimension. Comme la MCMC, la HMC génère une distribution de probabilité sur les paramètres ajustés, plutôt qu’une seule solution. Dans OghmaNano, la prise en charge est implémentée, mais elle n’a pas été testée de manière approfondie.
Sélection de morceaux « No-U-Turn » (NUTS)
Le programme No-U-Turn Sampler (NUTS) est une variante adaptative de l’algorithme HMC qui détermine automatiquement quand arrêter une trajectoire dans l’espace des paramètres afin d’éviter des calculs inutiles ou de répéter les mêmes étapes. Cela rend NUTS plus facile à utiliser, car cela réduit la nécessité d’ajuster manuellement les paramètres de l’algorithme. NUTS est largement considéré comme l’une des méthodes les plus efficaces et les plus robustes pour l’estimation bayésienne des paramètres. Dans OghmaNano, la prise en charge est implémentée, mais elle n’a pas été suffisamment testée.
👉 Prochaine étape : Continuez maintenant. Partie C pour des méthodes d’ajustement plus perfectionnées.