

Pokročilé metody montáže/instalacePokročilé metody montáže/instalace
1. Výběr vhodného minimalizátoru1. Výběr vhodného minimalizátoru
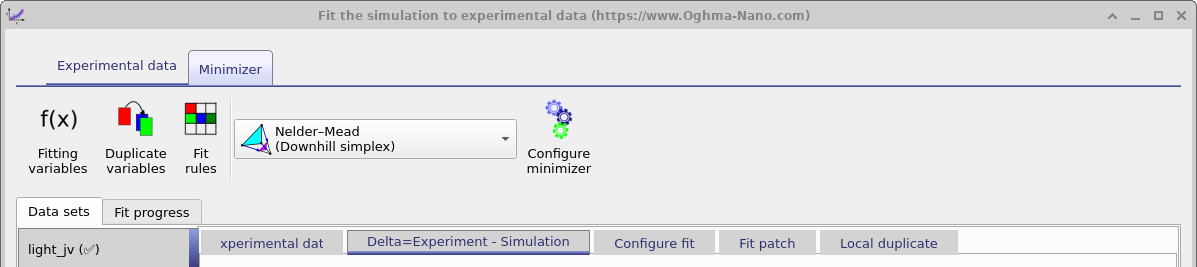
Pás karet „Minimizer“ slouží k výběru a konfiguraci algoritmu, který řídí proces optimalizace. Volba správného algoritmu může zásadně ovlivnit, zda bude optimalizace probíhat rychle a stabilně, nebo pomalu a nestabilně. OghmaNano nabízí několik osvědčených algoritmů, z nichž každý má jiné silné stránky. Ty lze vybrat z rozbalovací nabídky „Metoda optimalizace“.Pás karet „Minimizer“ slouží k výběru a konfiguraci algoritmu, který řídí proces optimalizace. Volba správného algoritmu může zásadně ovlivnit, zda bude optimalizace probíhat rychle a stabilně, nebo pomalu a nestabilně. OghmaNano nabízí několik osvědčených algoritmů, z nichž každý má jiné silné stránky. Ty lze vybrat z rozbalovací nabídky „Metoda optimalizace“.
Obecně lze říci, že algoritmy pro optimalizaci se dělí do dvou kategorií. První kategorií jsou metody založené na principu „sestupného směru“ nebo na gradientu, které se snaží „kutálet kouli z kopce“, dokud nedosáhnou minimální hodnoty chyby. Některé z těchto metod vyžadují explicitní výpočet gradientu, což může být nákladné a problematické u složitých modelů; jiné metody tento výpočet nevyžadují a jsou obvykle robustnější. Druhou kategorií jsou statistické metody, které nejen hledají nejlepší řešení, ale také poskytují pravděpodobnostní rozdělení, které udává míru spolehlivosti a jedinečnosti řešení. Tyto metody jsou výpočetně náročnější, ale mohou poskytnout hlubší vhled do nejistoty parametrů.Obecně lze říci, že algoritmy pro optimalizaci se dělí do dvou kategorií. První kategorií jsou metody založené na principu „sestupného směru“ nebo na gradientu, které se snaží „kutálet kouli z kopce“, dokud nedosáhnou minimální hodnoty chyby. Některé z těchto metod vyžadují explicitní výpočet gradientu, což může být nákladné a problematické u složitých modelů; jiné metody tento výpočet nevyžadují a jsou obvykle robustnější. Druhou kategorií jsou statistické metody, které nejen hledají nejlepší řešení, ale také poskytují pravděpodobnostní rozdělení, které udává míru spolehlivosti a jedinečnosti řešení. Tyto metody jsou výpočetně náročnější, ale mohou poskytnout hlubší vhled do nejistoty parametrů.
| MetodaMetoda | Sjezdové lyžování / Sjezd.Sjezdové lyžování / Sjezd. | GradientGradient | StatistickýStatistický | KomentářKomentář |
|---|---|---|---|---|
| Nelder-Meadova metodaNelder-Meadova metoda | ✅✅ | ❌❌ | ❌❌ | Odolný, pomalý, spolehlivý.Odolný, pomalý, spolehlivý. |
| NewtonNewton | ✅✅ | ✅✅ | ❌❌ | Křehké, někdy rychlé.Křehké, někdy rychlé. |
| Tepelné žíháníTepelné žíhání | ❌❌ | ❌❌ | ✅✅ | Překvapivě dobrý.Překvapivě dobrý. |
| Metropolisův algoritmus Monte CarloMetropolisův algoritmus Monte Carlo | ❌❌ | ❌❌ | ✅✅ | ?? |
| HMCHMC | ❌❌ | ❌❌ | ✅✅ | ?? |
Nelder–Meadova metoda (metoda simplex)Nelder–Meadova metoda (metoda simplex)
Nelder–Meadův simplexový algoritmus je v OghmaNano nejrozšířenější metodou pro optimalizaci – ve skutečnosti se na ni opíraly všechny publikované studie až do roku 2024. Obecný úvod do této metody naleznete zde: https://en.wikipedia.org/wiki/Nelder%E2%80%93Mead_method. V praxi je tento algoritmus robustní a nevyžaduje výpočet gradientů, což z něj činí vhodný nástroj pro řešení složitých problémů. Mezi jeho hlavní konfigurační možnosti patří:Nelder–Meadův simplexový algoritmus je v OghmaNano nejrozšířenější metodou pro optimalizaci – ve skutečnosti se na ni opíraly všechny publikované studie až do roku 2024. Obecný úvod do této metody naleznete zde: https://en.wikipedia.org/wiki/Nelder%E2%80%93Mead_method. V praxi je tento algoritmus robustní a nevyžaduje výpočet gradientů, což z něj činí vhodný nástroj pro řešení složitých problémů. Mezi jeho hlavní konfigurační možnosti patří:
- Zastavení procesu: Ukončí proces optimalizace, pokud se chyba nezlepší ani po provedení stanoveného počtu kroků.Zastavení procesu: Ukončí proces optimalizace, pokud se chyba nezlepší ani po provedení stanoveného počtu kroků.
- Zakázat reset na dané úrovni: Zabrání algoritmu v opakovaném spuštění, jakmile hodnota chyby klesne pod definovanou mez.Zakázat reset na dané úrovni: Zabrání algoritmu v opakovaném spuštění, jakmile hodnota chyby klesne pod definovanou mez.
- Dosažení konvergence: Definuje úroveň chyby, při které se považuje, že proces dosáhl konvergence a může být ukončen.Dosažení konvergence: Definuje úroveň chyby, při které se považuje, že proces dosáhl konvergence a může být ukončen.
- Počáteční multiplikátor pro simplexní algoritmus: Určuje velikost počáteční změny parametrů. Hodnoty větší než 1,0 podporují rozsáhlejší prohledávání prostoru parametrů; hodnoty menší než 1,0 udržují výsledek blízko počátečnímu odhadu. Obecně platí, že 2,0 je „velká“ hodnota a 0,1 je „malá“ hodnota.Počáteční multiplikátor pro simplexní algoritmus: Určuje velikost počáteční změny parametrů. Hodnoty větší než 1,0 podporují rozsáhlejší prohledávání prostoru parametrů; hodnoty menší než 1,0 udržují výsledek blízko počátečnímu odhadu. Obecně platí, že 2,0 je „velká“ hodnota a 0,1 je „malá“ hodnota.
- Povolte vytváření snímků během optimalizace: Ve výchozím nastavení jsou snímky vypnuté, aby se snížil počet přístupů k disku. Pokud tuto funkci zapnete, snímky se budou ukládat v každém kroku, což však sníží výkon.Povolte vytváření snímků během optimalizace: Ve výchozím nastavení jsou snímky vypnuté, aby se snížil počet přístupů k disku. Pokud tuto funkci zapnete, snímky se budou ukládat v každém kroku, což však sníží výkon.
- Postup pro reset algoritmu Simplex: Určuje, kolik kroků se provede před provedením resetu algoritmu Simplex. Reset může pomoci uniknout z lokálních minim, ale také může posunout řešení od bodu konvergence.Postup pro reset algoritmu Simplex: Určuje, kolik kroků se provede před provedením resetu algoritmu Simplex. Reset může pomoci uniknout z lokálních minim, ale také může posunout řešení od bodu konvergence.
Hlavní výhodou metody Neldera–Meada je její jednoduchost a spolehlivost. Z hlediska principu „kutálí kouli z kopce dolů“ směrem k minimu chybové funkce, aniž by vyžadovala výpočet gradientu, což je zvláště užitečné pro modely, které jsou zatíženy šumem nebo jsou nespojité.Hlavní výhodou metody Neldera–Meada je její jednoduchost a spolehlivost. Z hlediska principu „kutálí kouli z kopce dolů“ směrem k minimu chybové funkce, aniž by vyžadovala výpočet gradientu, což je zvláště užitečné pro modely, které jsou zatíženy šumem nebo jsou nespojité.
💡 Praktické tipy pro používání metody Neldera–Meada💡 Praktické tipy pro používání metody Neldera–Meada
- Pro většinu problémů optimalizace doporučujeme začít s metodou Nelder–Meada. K jiným metodám optimalizace přejděte pouze v případě, že se metoda Nelder–Meada nekonverguje, nebo pokud potřebujete získat statistické informace.Pro většinu problémů optimalizace doporučujeme začít s metodou Nelder–Meada. K jiným metodám optimalizace přejděte pouze v případě, že se metoda Nelder–Meada nekonverguje, nebo pokud potřebujete získat statistické informace.
- Tato metoda byla použita ve všech publikacích OghmaNano až do roku 2024, čímž se prokázala její účinnost a spolehlivost jako základ pro zajištění reprodukovatelnosti výsledků.Tato metoda byla použita ve všech publikacích OghmaNano až do roku 2024, čímž se prokázala její účinnost a spolehlivost jako základ pro zajištění reprodukovatelnosti výsledků.
- Metoda Neldera–Meada může být pomalá u problémů s velkým počtem proměnných (tj. při současném optimalizaci mnoha proměnných).Metoda Neldera–Meada může být pomalá u problémů s velkým počtem proměnných (tj. při současném optimalizaci mnoha proměnných).
- Vždy se snažte minimalizovat počet proměnných, které se používají pro odhad parametrů modelu, a to pouze na ty, které jsou skutečně nezbytné – tím se sníží počet dimenzí a zlepší se konvergence.Vždy se snažte minimalizovat počet proměnných, které se používají pro odhad parametrů modelu, a to pouze na ty, které jsou skutečně nezbytné – tím se sníží počet dimenzí a zlepší se konvergence.
- Nejprve proveďte jednu iteraci, abyste ověřili citlivost modelu, než se rozhodnete pro plně automatické optimalizační nastavení.Nejprve proveďte jednu iteraci, abyste ověřili citlivost modelu, než se rozhodnete pro plně automatické optimalizační nastavení.
Tepelné žíháníTepelné žíhání
Termické žíhání je stochastická optimalizační metoda, která vychází z fyzikálního procesu ochlazování materiálu z vysoké teploty na nízkou teplotu. V OghmaNano tento algoritmus prozkoumává prostor parametrů definovaný proměnlivými limity, které uživatel zadá. Správné nastavení těchto limitů je zásadní – minimalizační algoritmus nebude hledat mimo jejich rozsah.Termické žíhání je stochastická optimalizační metoda, která vychází z fyzikálního procesu ochlazování materiálu z vysoké teploty na nízkou teplotu. V OghmaNano tento algoritmus prozkoumává prostor parametrů definovaný proměnlivými limity, které uživatel zadá. Správné nastavení těchto limitů je zásadní – minimalizační algoritmus nebude hledat mimo jejich rozsah.
V praxi se ukazuje, že termální žíhání často funguje překvapivě dobře a může být rychlejší než metoda Neldera–Meada při hledání rozumného řešení. Nicméně, výsledné odhady nemusí být vždy tak přesné nebo „dokonalé“ a může být stále nutné provést další doladění pomocí metody Neldera–Meada. Termální žíhání je zvláště užitečné pro nalezení cesty z lokálních minim a pro komplexní prohledávání prostoru parametrů.V praxi se ukazuje, že termální žíhání často funguje překvapivě dobře a může být rychlejší než metoda Neldera–Meada při hledání rozumného řešení. Nicméně, výsledné odhady nemusí být vždy tak přesné nebo „dokonalé“ a může být stále nutné provést další doladění pomocí metody Neldera–Meada. Termální žíhání je zvláště užitečné pro nalezení cesty z lokálních minim a pro komplexní prohledávání prostoru parametrů.
- Ukládej data každých n kroků: Uloží aktuální stav na disk v zadaných intervalech.Ukládej data každých n kroků: Uloží aktuální stav na disk v zadaných intervalech.
- Konstanta ochlazování: Určuje, jak rychle „teplota“ v simulaci klesá. Ochlazování probíhá podle vzorce \( e^{-k(T_{\text{start}}-T_{\text{stop}})} \), kde \(T_{\text{start}} = 300\,K\) a \(T_{\text{stop}} = 0\,K\).Konstanta ochlazování: Určuje, jak rychle „teplota“ v simulaci klesá. Ochlazování probíhá podle vzorce \( e^{-k(T_{\text{start}}-T_{\text{stop}})} \), kde \(T_{\text{start}} = 300\,K\) a \(T_{\text{stop}} = 0\,K\).
- Kroky žíhání: Počet iterací použitých ke snížení teploty systému z \(T_{\text{start}}\) na \(T_{\text{stop}}\).Kroky žíhání: Počet iterací použitých ke snížení teploty systému z \(T_{\text{start}}\) na \(T_{\text{stop}}\).
💡 Tipy pro použití tepelného žíhání💡 Tipy pro použití tepelného žíhání
- Nejlépe se používá v případech, kdy algoritmus Nelder–Meada uvízne v lokálním minimu.Nejlépe se používá v případech, kdy algoritmus Nelder–Meada uvízne v lokálním minimu.
- Pečlivě nastavte hranice parametrů – algoritmus nebude hledat mimo tyto hranice.Pečlivě nastavte hranice parametrů – algoritmus nebude hledat mimo tyto hranice.
- Očekávejte rychlejší konvergenci než u metody Neldera–Meada, ale výsledky nebudou tak přesné.Očekávejte rychlejší konvergenci než u metody Neldera–Meada, ale výsledky nebudou tak přesné.
- Zvažte možnost, že po simulovaném žíhání použijete algoritmus Neldera–Meada, abyste vylepšili získané řešení.Zvažte možnost, že po simulovaném žíhání použijete algoritmus Neldera–Meada, abyste vylepšili získané řešení.
NewtonNewton
Newtonova metoda je v OghmaNano zahrnuta pro úplnost, ale v mnoha případech se nejedná o nejlepší řešení. Protože se jedná o minimalizační algoritmus založený na gradientu, vyžaduje, aby se v každém kroku vypočítaly derivace. I když to v některých případech může vést k rychlejšímu výpočtu než u metody Neldera–Meada, zejména u hladkých a dobře definovaných problémů, zároveň to činí algoritmus citlivým: malé numerické chyby při výpočtu derivací mohou způsobit, že se výsledek bude rozcházet nebo že se výpočet zastaví.Newtonova metoda je v OghmaNano zahrnuta pro úplnost, ale v mnoha případech se nejedná o nejlepší řešení. Protože se jedná o minimalizační algoritmus založený na gradientu, vyžaduje, aby se v každém kroku vypočítaly derivace. I když to v některých případech může vést k rychlejšímu výpočtu než u metody Neldera–Meada, zejména u hladkých a dobře definovaných problémů, zároveň to činí algoritmus citlivým: malé numerické chyby při výpočtu derivací mohou způsobit, že se výsledek bude rozcházet nebo že se výpočet zastaví.
V praxi je Newtonova metoda velmi citlivá na počáteční odhad a na škálování proměnných. Pokud není problém velmi jednoduchý a dobře definovaný, konvergence je často nedostatečná. Z těchto důvodů se obecně nedoporučuje jako primární metoda, ale může být užitečná jako diagnostický nástroj nebo pro experimentování v kontrolovaných případech.V praxi je Newtonova metoda velmi citlivá na počáteční odhad a na škálování proměnných. Pokud není problém velmi jednoduchý a dobře definovaný, konvergence je často nedostatečná. Z těchto důvodů se obecně nedoporučuje jako primární metoda, ale může být užitečná jako diagnostický nástroj nebo pro experimentování v kontrolovaných případech.
💡 Tipy pro používání Newtonovy metody💡 Tipy pro používání Newtonovy metody
- Metodu Newtona používejte pouze u malých a hladkých problémů, u kterých jsou k dispozici dobré počáteční odhady.Metodu Newtona používejte pouze u malých a hladkých problémů, u kterých jsou k dispozici dobré počáteční odhady.
- Ujistěte se, že rozsah proměnných je vhodně nastaven – nesprávné nastavení může vést k odchylkám.Ujistěte se, že rozsah proměnných je vhodně nastaven – nesprávné nastavení může vést k odchylkám.
- Pokud algoritmus Newton nedosáhne konvergence, použijte alternativně algoritmus Nelder–Meada nebo metodu termálního žíhání.Pokud algoritmus Newton nedosáhne konvergence, použijte alternativně algoritmus Nelder–Meada nebo metodu termálního žíhání.
- Newton používejte především pro testování nebo zkoumání konkrétních případů, nikoli pro finální implementaci.Newton používejte především pro testování nebo zkoumání konkrétních případů, nikoli pro finální implementaci.
Markovův řetězec a metoda Monte Carlo (MCMC)Markovův řetězec a metoda Monte Carlo (MCMC)
Markovův řetězec Monte Carlo (MCMC) je statistická metoda pro optimalizaci, která náhodně vybírá hodnoty z prostoru parametrů, avšak takovým způsobem, že v průběhu času vytváří správné pravděpodobnostní rozdělení. Na rozdíl od metod Nelder–Mead nebo Newton, které vrací jedinou sadu „nejlepších“ parametrů, MCMC generuje rozdělení řešení, které ukazuje, jak pravděpodobné jsou různé hodnoty parametrů. Díky tomu je tato metoda obzvláště účinná pro kvantifikaci nejistoty a identifikaci korelací mezi proměnnými. V OghmaNano je tato funkce implementována, ale nebyla důkladně otestována.Markovův řetězec Monte Carlo (MCMC) je statistická metoda pro optimalizaci, která náhodně vybírá hodnoty z prostoru parametrů, avšak takovým způsobem, že v průběhu času vytváří správné pravděpodobnostní rozdělení. Na rozdíl od metod Nelder–Mead nebo Newton, které vrací jedinou sadu „nejlepších“ parametrů, MCMC generuje rozdělení řešení, které ukazuje, jak pravděpodobné jsou různé hodnoty parametrů. Díky tomu je tato metoda obzvláště účinná pro kvantifikaci nejistoty a identifikaci korelací mezi proměnnými. V OghmaNano je tato funkce implementována, ale nebyla důkladně otestována.
Hamiltonovská metoda Monte Carlo (HMC)Hamiltonovská metoda Monte Carlo (HMC)
Hamiltonovská metoda Monte Carlo (HMC) rozšiřuje koncept MCMC tím, že využívá informace o gradientu k navrhování efektivnějších kroků v prostoru parametrů. Místo náhodného pohybu HMC simuluje „pohyb“ částice v prostoru pravděpodobnosti, přičemž se řídí gradienty, což může výrazně zlepšit efektivitu vzorkování u problémů s velkým počtem dimenzí. Stejně jako MCMC generuje HMC pravděpodobnostní rozdělení nad odhadnutými parametry, nikoli pouze jedno řešení. V OghmaNano je tato funkce implementována, ale nebyla důkladně otestována.Hamiltonovská metoda Monte Carlo (HMC) rozšiřuje koncept MCMC tím, že využívá informace o gradientu k navrhování efektivnějších kroků v prostoru parametrů. Místo náhodného pohybu HMC simuluje „pohyb“ částice v prostoru pravděpodobnosti, přičemž se řídí gradienty, což může výrazně zlepšit efektivitu vzorkování u problémů s velkým počtem dimenzí. Stejně jako MCMC generuje HMC pravděpodobnostní rozdělení nad odhadnutými parametry, nikoli pouze jedno řešení. V OghmaNano je tato funkce implementována, ale nebyla důkladně otestována.
Ukázka programu No-U-Turn (NUTS)Ukázka programu No-U-Turn (NUTS)
No-U-Turn Sampler (NUTS) je adaptivní varianta algoritmu HMC, která automaticky rozhoduje, kdy ukončit výpočet trajektorie v prostoru parametrů, aby se předešlo zbytečnému výpočetnímu úsilí nebo opakování již propočtených cest. Díky tomu je NUTS uživatelsky přívětivější, protože snižuje potřebu ručního ladění parametrů algoritmu. NUTS je všeobecně považován za jeden z nejefektivnějších a nejspolehlivějších metod pro bayesovské odhadování parametrů. V OghmaNano je implementována podpora pro NUTS, ale nebyla provedena důkladná testování.No-U-Turn Sampler (NUTS) je adaptivní varianta algoritmu HMC, která automaticky rozhoduje, kdy ukončit výpočet trajektorie v prostoru parametrů, aby se předešlo zbytečnému výpočetnímu úsilí nebo opakování již propočtených cest. Díky tomu je NUTS uživatelsky přívětivější, protože snižuje potřebu ručního ladění parametrů algoritmu. NUTS je všeobecně považován za jeden z nejefektivnějších a nejspolehlivějších metod pro bayesovské odhadování parametrů. V OghmaNano je implementována podpora pro NUTS, ale nebyla provedena důkladná testování.