

Створення наборів даних для машинного навчання
У цьому розділі описано, як створювати набори даних для машинного навчання за допомогою OghmaNano. Зазвичай ці набори даних експортуються та обробляються за допомогою зовнішніх фреймворків, таких як TensorFlow, для навчання, здійснення висновків або прогнозування.
1. Вступ
Часто виникає потреба в отриманні фізичних параметрів пристрою на основі експериментальних даних за допомогою моделювання. Наприклад, якщо є набір кривих залежності струму від напруги, може знадобитися визначити рухливість носіїв заряду та швидкість рекомбінації в пристрої. Традиційно це досягається шляхом підгонки фізичної моделі, наприклад, OghmaNano, до даних (як описано в посібник з підгонки). Недоліком цього підходу є те, що підгонка одного набору даних може займати багато часу, і складність значно зростає, коли необхідно проаналізувати кілька наборів даних. Процес підгонки є складним і зазвичай вимагає значних знань у галузі чисельного моделювання та значної кількості ручних коригувань. Як наслідок, детальну підгонку параметрів пристрою виконує лише відносно невелика група фахівців.
Більш сучасний підхід полягає у використанні машинного навчання. Замість того, щоб безпосередньо підганяти єдину криву залежності струму від напруги (JV), спочатку створюється модель, яка відображає структуру пристрою. Замість оптимізації окремих електричних параметрів, генеруються тисячі копій цього пристрою з випадково підібраними значеннями параметрів. Кожна з цих копій називається віртуальним пристроєм. Потім використовується програма моделювання, наприклад OghmaNano, для створення кривих JV для кожного віртуального пристрою, в результаті чого утворюється набір даних, що складається з кривих JV, з’єднаних з відповідними електричними параметрами. Ці дані можна використовувати для навчання моделі машинного навчання, щоб безпосередньо прогнозувати електричні параметри на основі характеристик кривих JV. У цій структурі OghmaNano виконує роль прямої трансформації, відображаючи електричні параметри на змодельовані експериментальні дані, тоді як модель машинного навчання забезпечує зворотну трансформацію. Після навчання модель можна використовувати для отримання параметрів матеріалу з реальних пристроїв.
Основна перевага цього підходу полягає в тому, що після навчання модель машинного навчання може витягувати важливі параметри з експериментальних даних за лічені секунди, не вимагаючи від користувача спеціальних знань у галузі чисельного моделювання. Однак успіх цього методу критично залежить від створення великого набору високоякісних навчальних даних. Процес створення таких наборів даних за допомогою OghmaNano описано в наступних розділах.
2. Відкриття прикладу
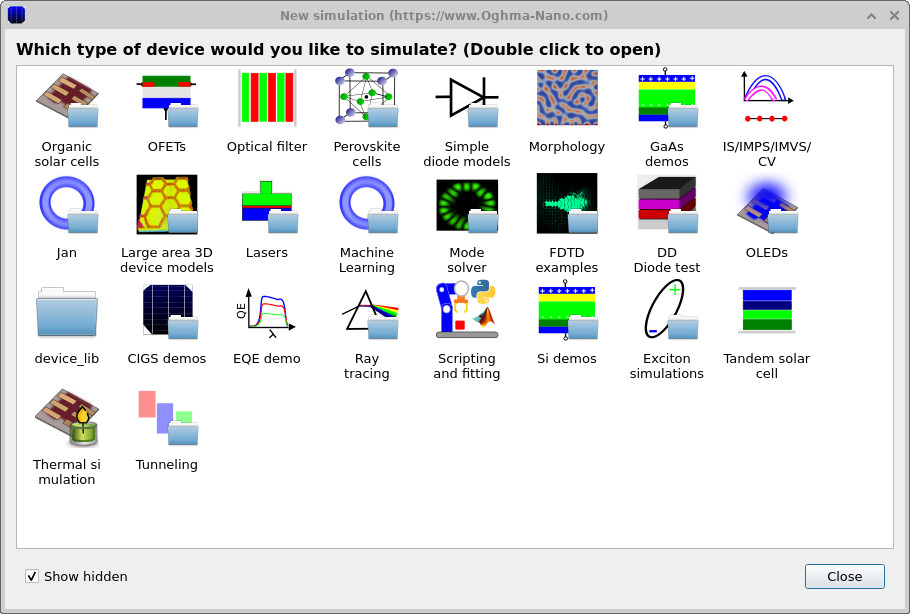
Приклад, про який йдеться на цій сторінці, можна відкрити, натиснувши кнопку «Нова симуляція» в головному вікні. Відкриється вікно переглядача нової симуляції, зображене на ??.
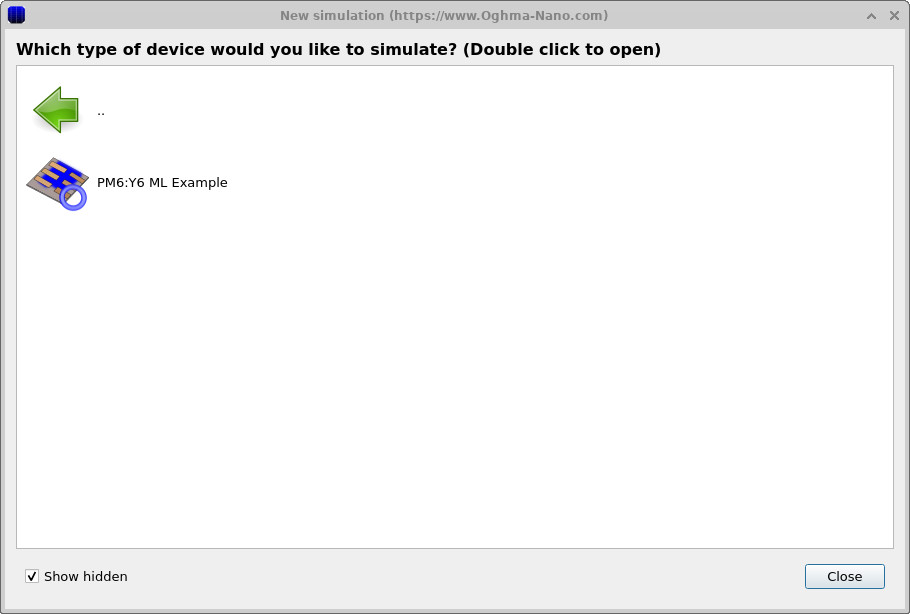
У списку доступних категорій моделювання двічі клацніть на пункті «Машинне навчання», щоб переглянути приклади машинного навчання (??). Вибір прикладу «PM6:Y6 ML» завантажує попередньо налаштовану модель, яка відповідає пристрою та робочому процесу, описаним у цьому розділі.
Після відкриття симуляція відображає ту саму структуру пристрою та налаштування автоматизації, які використовуються в усьому цьому розділі, і її можна безпосередньо використовувати для створення даних для навчання моделей машинного навчання без додаткової конфігурації.
3. Визначення параметрів моделювання та векторів результатів.
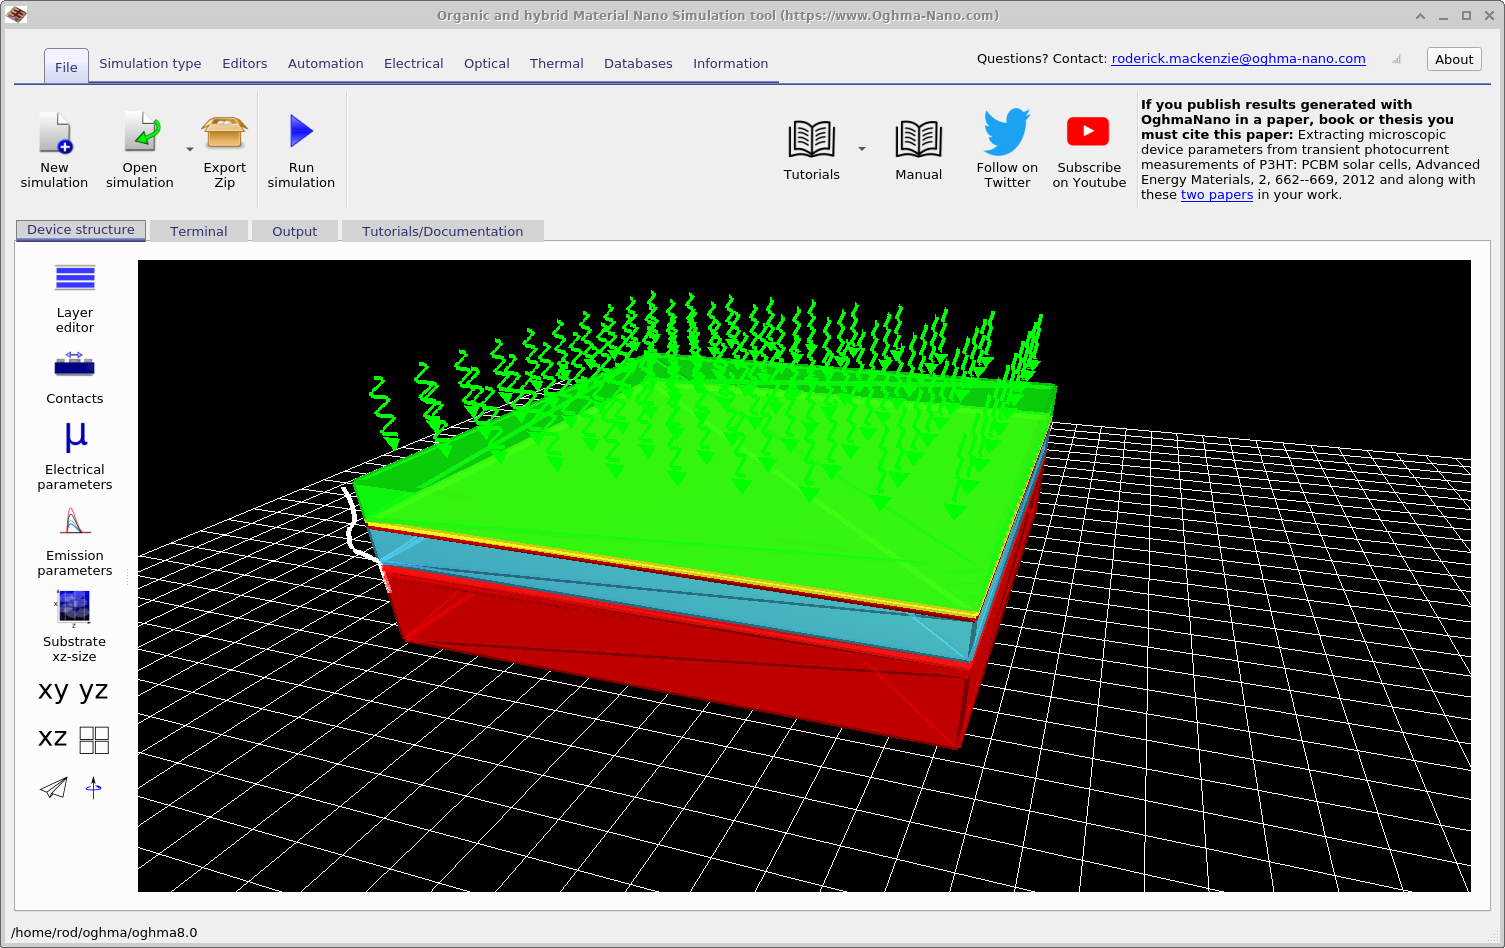
Після відкриття демонстраційного моделювання перед вами з’явиться головне вікно моделювання, зображене на рисунку ??. У цьому вікні відображається повністю налаштована структура пристрою, яка використовується протягом усього розділу. На стрічці інструментів «Автоматизація» відображається піктограма «Машинне навчання», позначена синім круглим символом. Натискання на цю піктограму відкриває головне вікно керування машинним навчанням, зображене на рисунку ??. У цьому вікні налаштовується та запускається процес створення даних для навчання моделі машинного навчання.
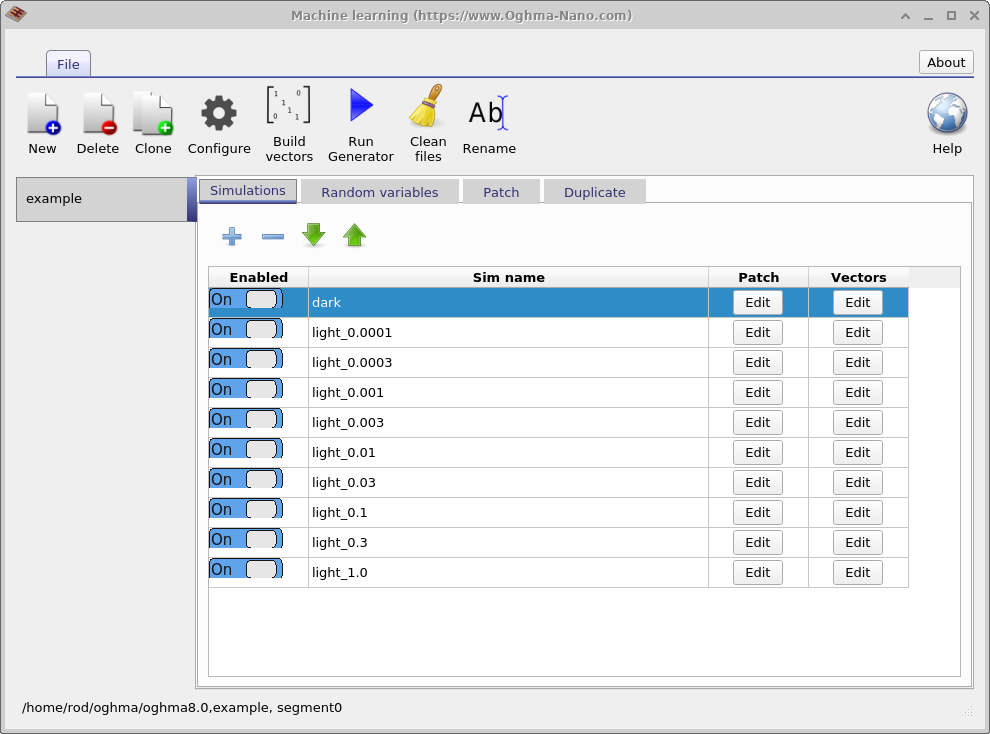
Основна мета цього вікна полягає в тому, щоб створювати великі набори даних для навчання алгоритмів машинного навчання. Набір даних, створений у цьому прикладі, називається «example». Перша вкладка, що відображається, – це вкладка «Симуляції», яка визначає набір симуляцій, що виконуються для кожного віртуального пристрою. У цьому випадку моделюється темна крива JV і дев’ять освітлених кривих JV, причому інтенсивність світла варіюється від 0,0001 сонячної одиниці до 1,0 сонячної одиниці. Окремі симуляції можна вмикати або вимикати за допомогою перемикача «Увімкнено». Якщо натиснути кнопку «Редагувати» в стовпці «Ділянка» для запису \(light\_0.0001\), відкривається вікно «Ділянка», показане на ??.
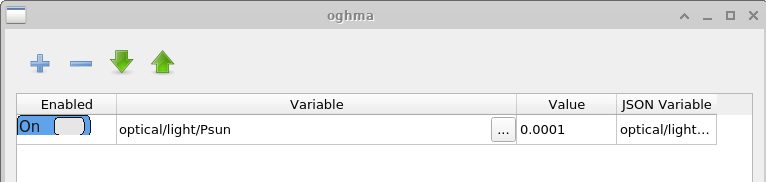
Призначення вікна «Patch» полягає в тому, щоб змінювати параметри у віртуальній симуляції. У цьому прикладі генерується кілька кривих JV за різних умов освітлення з використанням однієї й тієї ж базової структури пристрою. Для цього інтенсивність світла має бути налаштована окремо для кожної симуляції. Відкриття вікна «Patch» для \(light\_0.0001\) показує, що параметр симуляції «оптичний/світло/Psun», який контролює інтенсивність освітлення, встановлено на значення \(0.0001\). Для симуляції в умовах темряви той самий параметр встановлено на значення \(0.0\). Таким чином, можна послідовно змоделювати кілька експериментальних умов, використовуючи одну базову симуляцію.
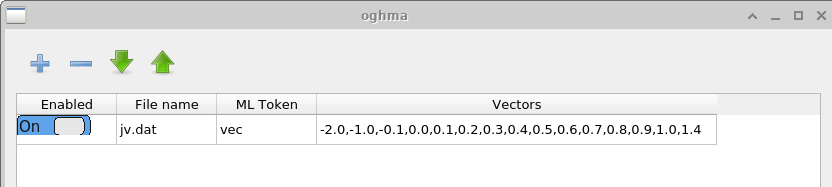
Вікно «Вектори» визначає, які дані витягуються з завершених симуляцій для формування вхідних векторів для машинного навчання. У цьому прикладі з файлу \(jv.dat\), який містить змодельовані характеристики струму та напруги, витягуються точки даних у діапазоні від −2,0 В до 1,4 В. Для симуляцій у часовій області користувач може натомість витягувати дані з файлів, таких як \(time\_i.csv\) або будь-який інший відповідний вихідний файл. Кількість точок, що використовуються для створення кожного вхідного вектора, визначається користувачем. Довші вектори збільшують обчислювальні витрати на навчання, але можуть охоплювати більш детальні характеристики кривої залежності струму від напруги.
4. Визначення випадкових величин
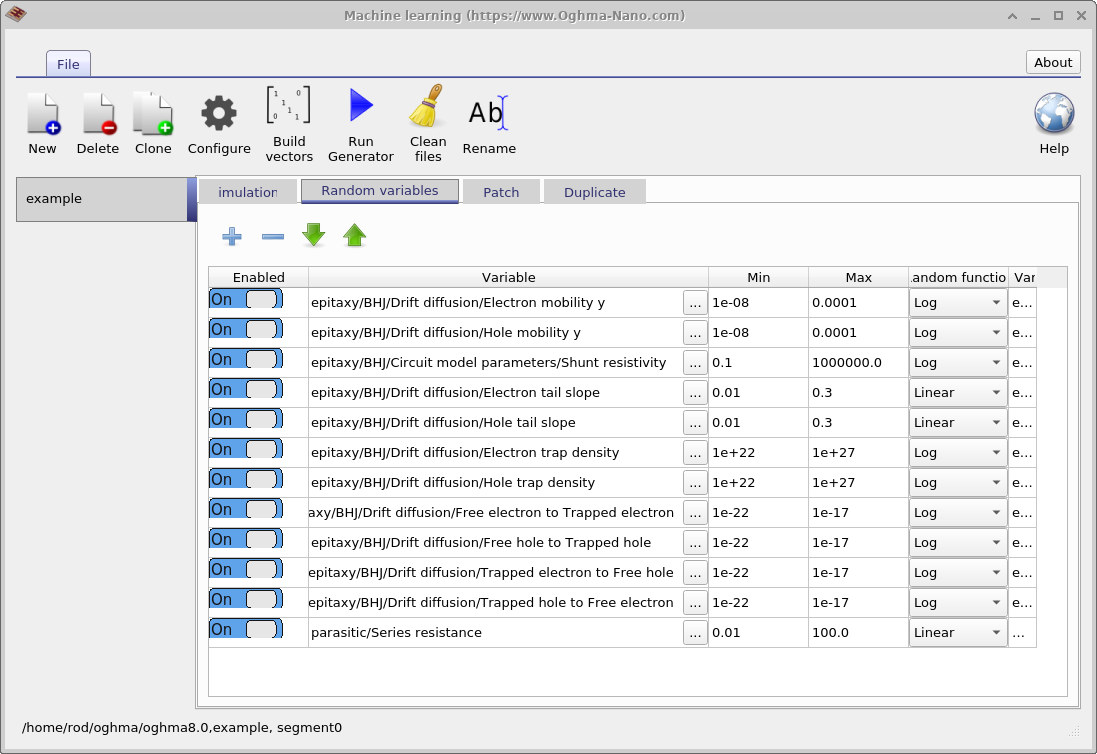
Наступний крок полягає у визначенні того, які параметри моделі підлягають випадковій зміні. Це робиться за допомогою вкладки «Випадкові змінні» в головному вікні машинного навчання. Таблиця містить п’ять стовпців. Стовпець «Увімкнено» визначає, чи береться параметр до уваги під час процесу випадкової зміни. Стовпець «Змінна» вказує, який параметр моделювання змінюється. Стовпці «Мін» і «Макс» визначають нижню та верхню межі діапазону параметра, а стовпець «Випадкова функція» вказує, чи значення беруться з лінійного чи логарифмічного розподілу.
Для параметрів, які охоплюють кілька порядків величин, рекомендується використовувати логарифмічні розподіли, тоді як лінійні розподіли підходять для параметрів, які змінюються в відносно вузькому діапазоні. Використання логарифмічного розподілу забезпечує рівномірний відбір значень при їх відображенні на логарифмічній шкалі, а не їх скупчення у верхній частині діапазону. Наприклад, відповідним лінійним параметром може бути енергія Урбаха, яка зазвичай змінюється в межах від 30 до 150 меВ. На противагу цьому, концентрації пасток добре підходять для логарифмічного відбору, оскільки вони можуть змінюватися від \(1 \times 10^{15}\,\mathrm{m^{-3}}\) до \(1 \times 10^{25}\,\mathrm{m^{-3}}\).
5. Визначення кількості моделювань.
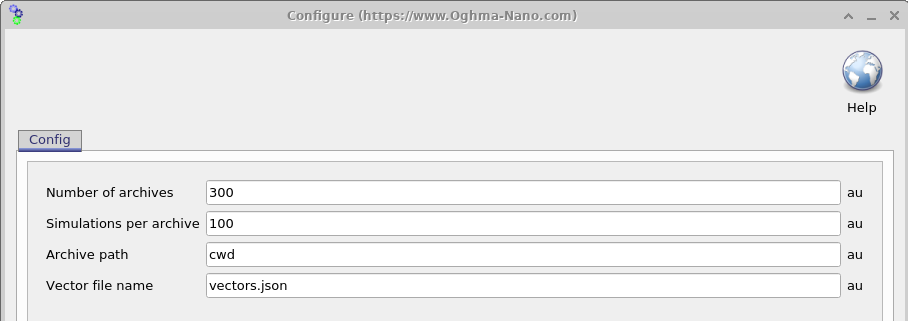
Після налаштування моделювання наступним кроком є визначення кількості віртуальних пристроїв із випадковими параметрами, які потрібно створити. Відкриття вікна «Налаштування» (див. 18.6) дозволяє керувати цим процесом за допомогою двох параметрів: «Кількість моделювань в архіві» (\(N_{\mathrm{sim}}\)) і «Кількість архівів» (\(N_{\mathrm{arc}}\)). Загальна кількість створених віртуальних пристроїв відображається у \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\).
Результати моделювання зберігаються у ZIP-файлах, які називаються архівами, причому кожен архів містить \(N_{\mathrm{sim}}\) віртуальних пристроїв. У наведеному прикладі генерується та зберігається 100 архівних файлів, кожен з яких містить \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) віртуальних пристроїв. Важливо зазначити, що в цьому прикладі кожен віртуальний пристрій складається з однієї моделі темного p-n переходу та дев’яти моделей освітленого p-n переходу. Як наслідок, загальна кількість вихідних файлів може швидко зростати.
Для цього дані генеруються партіями. Група з \(N_{\mathrm{sim}}\) симуляцій генерується та запускається програмою OghmaNano, потім записується в єдиний архів, і цей процес повторюється до тих пір, поки не буде створено \(N_{\mathrm{arc}}\) архівів. Такий підхід обмежує втрату даних до архіву, який зараз генерується, у випадку переривання процесу, а також спрощує передачу файлів і підвищує стійкість до пошкоджень. Виконання симуляцій відбувається паралельно на всіх доступних ядрах процесора, тоді як створення архіву здійснюється на одному ядрі.
6. Запуск генератора набору даних.
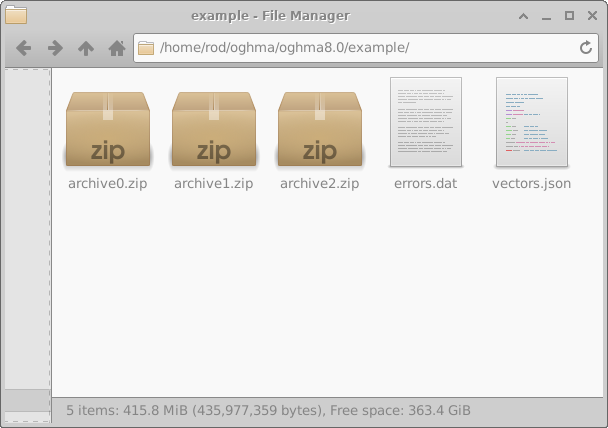
Після завершення налаштування, натискання кнопки «Запустити генератор» у головному вікні машинного навчання (18.2) запускає процес створення набору даних. Після цього OghmaNano розпочне виконання симуляцій, визначених для кожного віртуального пристрою. Після завершення процесу в каталозі симуляцій з’явиться папка під назвою «example», як показано в лівій частині 18.8. Для цілей цього прикладу значення «Кількість симуляцій на архів» було встановлено на 10, а «Кількість архівів» – на 3, щоб скоротити час виконання.
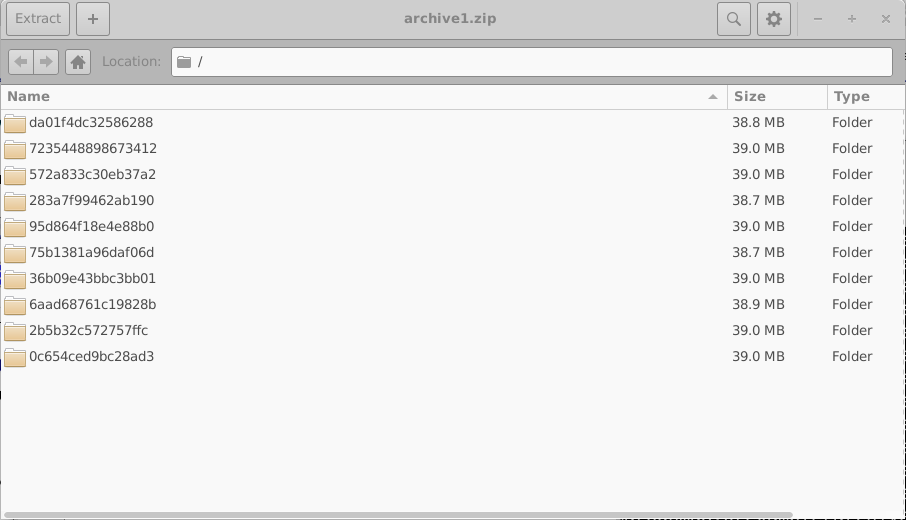
Усі помилки, виявлені під час моделювання, записуються у файл errors.dat. Відкриття архіву archive0.zip показує внутрішню структуру архіву, яка відображається у правій частині 18.8. Кожен архів містить набір каталогів, кожен з яких відповідає одному віртуальному пристрою.
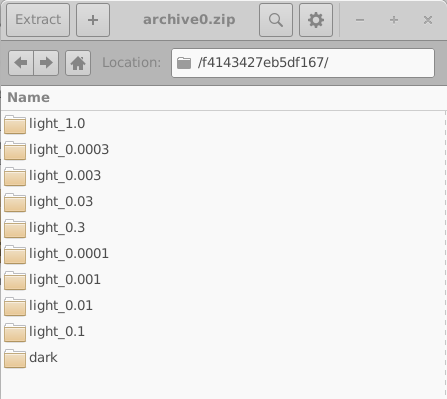
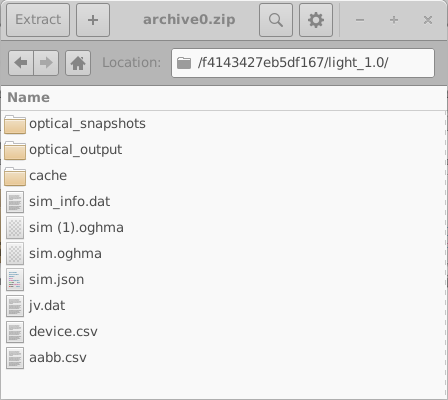
Ці каталоги мають імена, що генеруються випадковим чином і складаються з 16-значних шістнадцяткових ідентифікаторів. Кожен каталог містить повний набір симуляцій для одного віртуального пристрою; у цьому прикладі – одну симуляцію «темного» пристрою та дев’ять симуляцій «освітленого» пристрою. Зміст одного з таких каталогів показано в лівій частині 18.10. Відкриття окремого каталогу симуляцій (18.10, праворуч) показує повну симуляцію OghmaNano, включно з файлом sim.json і файлом jv.dat, який містить змодельовані характеристики струму та напруги. Крім того, можуть бути присутні додаткові дані, такі як оптичні вихідні дані та файли кешу.
Під час створення великих наборів даних для машинного навчання настійно рекомендується мінімізувати непотрібний вивід, оскільки загальний обсяг даних, що зберігаються на диску, може швидко зростати. Це можна досягти шляхом налаштування моделювання таким чином, щоб воно генерувало лише необхідні дані. Створення наборів даних здійснюється партіями, при цьому моделювання виконується паралельно на всіх доступних ядрах процесора, а створення архіву здійснюється на одному ядрі.
У цьому наведеному прикладі створюється лише три архіви. Однак, у типовому виробничому процесі зазвичай створюється близько 200 архівів, і кожен з них містить приблизно 200 віртуальних пристроїв.
In the above example we only have three archives but in a normal simulation run one would have up to 200 archives each with 200 simulations in each.
7. Зведення результатів в один файл.
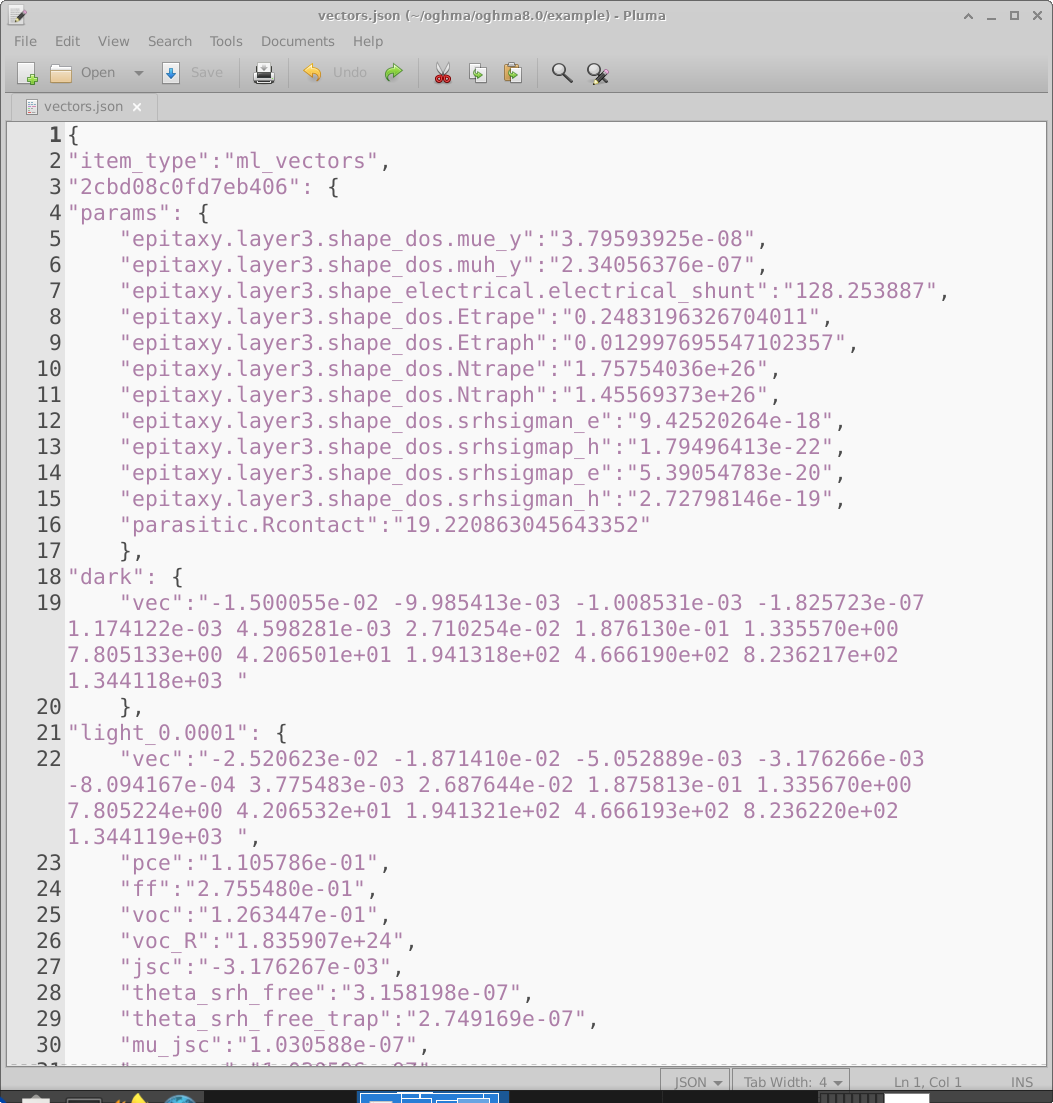
Після завершення моделювання необроблені дані, отримані від OghmaNano, необхідно перетворити на єдиний файл векторів, придатний для навчання моделі машинного навчання. Натискання на піктограму «Створити вектори» в головному вікні машинного навчання (18.2) призводить до того, що OghmaNano відкриває кожну віртуальну папку пристрою, витягує необхідні дані та об’єднує їх в єдиний файл vectors.json. Приклад цього файлу наведено в 18.11.
Файл векторів – це документ у форматі JSON, який містить усю інформацію, необхідну для навчання з учителем. Кожен віртуальний пристрій представлений як окремий запис. Наприклад, запис під назвою 2cbd08c0fd7eb406 (рядок 3) містить в розділі «params» електричні параметри, випадково обрані для цього віртуального пристрою. Далі наводяться отримані вхідні вектори, такі як вектор темнової характеристики (рядок 19) і вектор характеристики при освітленні 0,0001 сонячної одиниці (рядок 22). Числові одиниці вимірювання кожного вектора безпосередньо успадковуються з вихідного файлу, з якого вони були отримані. У цьому прикладі вектори взяті з файлу jv.dat, який зберігає щільність струму \(A\,m^{-2}\) як функцію напруги, тому значення векторів вказані в \(A\,m^{-2}\). Після вхідних векторів для зручності зберігаються додаткові скалярні вихідні дані (наприклад, PCE).
У цьому файлі буде створено один запис для кожного згенерованого віртуального пристрою. Після створення файлу vectors.json його можна використовувати як набір даних для навчання в обраному вами процесі машинного навчання. Деяким користувачам зручніше імпортувати дані в TensorFlow після їх перетворення у формат CSV; це можна зробити за допомогою стандартних бібліотек Python.
8. From data set to machine learning
У попередніх розділах описано, як OghmaNano використовується для створення повного набору даних для машинного навчання у форматі JSON. На цьому етапі процес створення даних завершено: для кожного віртуального пристрою файл містить випадково обрані параметри моделі разом із відповідними результатами моделювання, закодованими у вигляді вхідних векторів.
Наступний крок полягає в тому, щоб імпортувати ці дані в обрану вами систему машинного навчання. На практиці це зазвичай передбачає зчитування файлу vectors.json і перетворення його в табличний формат, наприклад, CSV, який потім можна використовувати для навчання, перевірки та тестування. Це перетворення можна легко виконати за допомогою стандартних інструментів для створення сценаріїв (наприклад, Python).
Після перетворення отримані дані можна використовувати для навчання нейронної мережі або іншої регресійної моделі, реалізованої за допомогою платформи машинного навчання, наприклад, TensorFlow, PyTorch або подібної бібліотеки. З цього моменту вибір архітектури мережі, функції втрат і стратегії навчання залежить від конкретного застосування та не пов’язаний з OghmaNano.
Таким чином, OghmaNano забезпечує комплексний та автоматизований процес для створення фізично узгоджених навчальних даних, передаючи подальшу розробку та оптимізацію моделі машинного навчання повністю під контроль користувача.