

Tworzenie zbiorów danych do uczenia maszynowego
W tym rozdziale opisano, jak tworzyć zbiory danych do uczenia maszynowego za pomocą OghmaNano. Zazwyczaj zbiory te są eksportowane i przetwarzane przy użyciu zewnętrznych platform, takich jak TensorFlow, w celu trenowania, wnioskowania lub przewidywania.
1. Wprowadzenie
Często pożądane jest wyodrębnienie parametrów fizycznych urządzenia z danych eksperymentalnych za pomocą modelowania. Na przykład, możemy dysponować zestawem krzywych charakterystyki prądowo-napięciowej (JV) i chcieć określić ruchliwość nośników ładunku oraz szybkość rekombinacji w urządzeniu. Tradycyjnie osiąga się to poprzez dopasowanie modelu opartego na zasadach fizyki, takiego jak OghmaNano, do danych (jak opisano w instrukcji dopasowania). Wadą tego podejścia jest to, że dopasowanie pojedynczego zestawu danych może być czasochłonne, a trudność znacznie wzrasta, gdy należy przeanalizować wiele zestawów danych. Proces dopasowania jest złożony i zazwyczaj wymaga znacznej wiedzy specjalistycznej w zakresie symulacji numerycznych oraz dużej ilości ręcznych interwencji. W rezultacie, szczegółowe dopasowanie parametrów urządzenia jest wykonywane tylko przez stosunkowo niewielką grupę osób.
Bardziej nowoczesne podejście polega na wykorzystaniu uczenia maszynowego. Zamiast bezpośredniego dopasowywania pojedynczej krzywej charakterystyki prądowo-napięciowej (JV), najpierw tworzy się symulację, która odzwierciedla strukturę urządzenia. Zamiast optymalizować poszczególne parametry elektryczne, generuje się tysiące kopii tego urządzenia z losowo wybranymi wartościami parametrów. Każda z tych kopii jest określana jako wirtualne urządzenie. Następnie wykorzystuje się program do symulacji, taki jak OghmaNano, do generowania krzywych charakterystyki prądowo-napięciowej dla każdego wirtualnego urządzenia, tworząc zbiór danych składający się z krzywych JV sparowanych z odpowiadającymi im parametrami elektrycznymi. Dane te można wykorzystać do wytrenowania modelu uczenia maszynowego, który będzie bezpośrednio przewidywał parametry elektryczne na podstawie charakterystyk JV. W tym modelu OghmaNano pełni funkcję transformacji bezpośredniej, mapując parametry elektryczne na symulowane dane eksperymentalne, podczas gdy model uczenia maszynowego zapewnia transformację odwrotną. Po wytrenowaniu model można zastosować do wyodrębniania parametrów materiałowych z rzeczywistych urządzeń.
Główną zaletą tego podejścia jest to, że po przeszkoleniu model uczenia maszynowego może w ciągu kilku sekund wyodrębniać parametry materiałowe z danych eksperymentalnych, bez konieczności, aby użytkownik był ekspertem w dziedzinie symulacji numerycznych. Jednak skuteczność tej metody w dużym stopniu zależy od stworzenia obszernego, wysokiej jakości zbioru danych treningowych. Proces tworzenia takich zbiorów danych przy użyciu OghmaNano opisano w kolejnych rozdziałach.
2. Otwieranie przykładu.
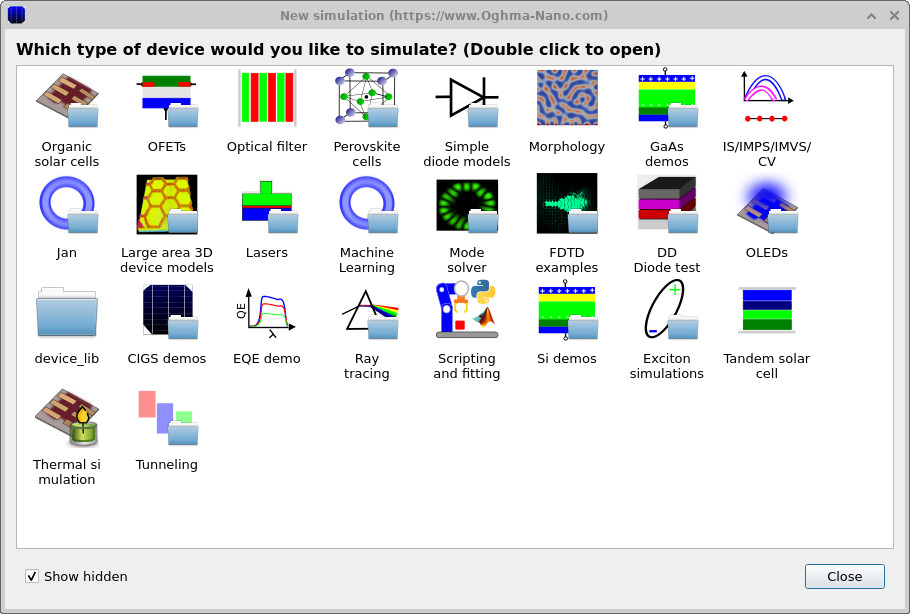
Przykład omówiony na tej stronie można uruchomić, klikając przycisk „Nowa symulacja” w głównym oknie. Spowoduje to otwarcie okna przeglądarki nowej symulacji, jak pokazano na ilustracji ??.
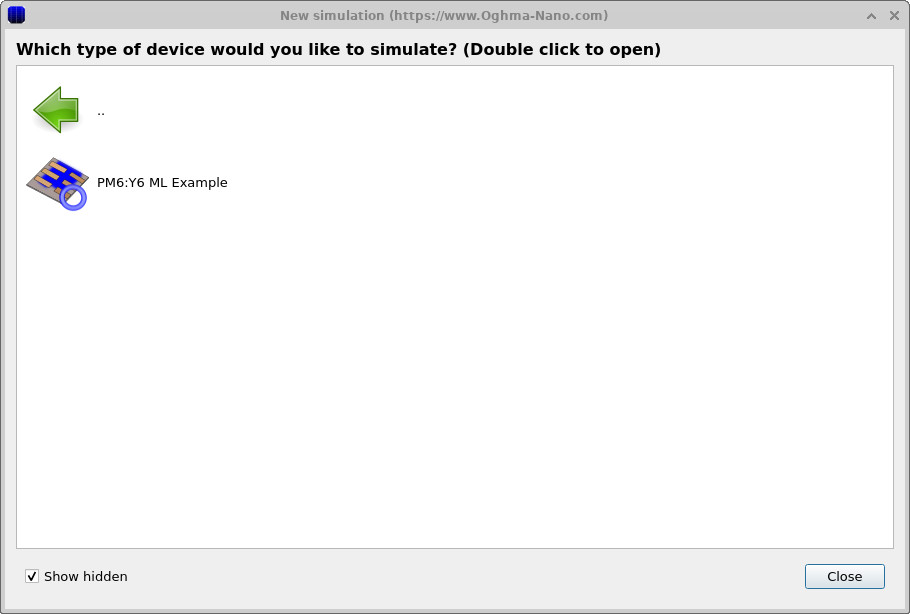
Na liście dostępnych kategorii symulacji kliknij dwukrotnie opcję „Uczenie maszynowe”, aby wyświetlić przykładowe symulacje z zakresu uczenia maszynowego (??). Wybranie przykładu PM6:Y6 ML powoduje załadowanie wstępnie skonfigurowanej symulacji, która odpowiada urządzeniu i procesowi opisanemu w tym rozdziale.
Po uruchomieniu symulacja prezentuje tę samą strukturę urządzenia i konfigurację automatyzacji, które są wykorzystywane w całej tej sekcji, i może być bezpośrednio używana do generowania danych treningowych dla uczenia maszynowego, bez konieczności dalszej konfiguracji.
3. Określenie parametrów symulacji i wektorów wyjściowych.
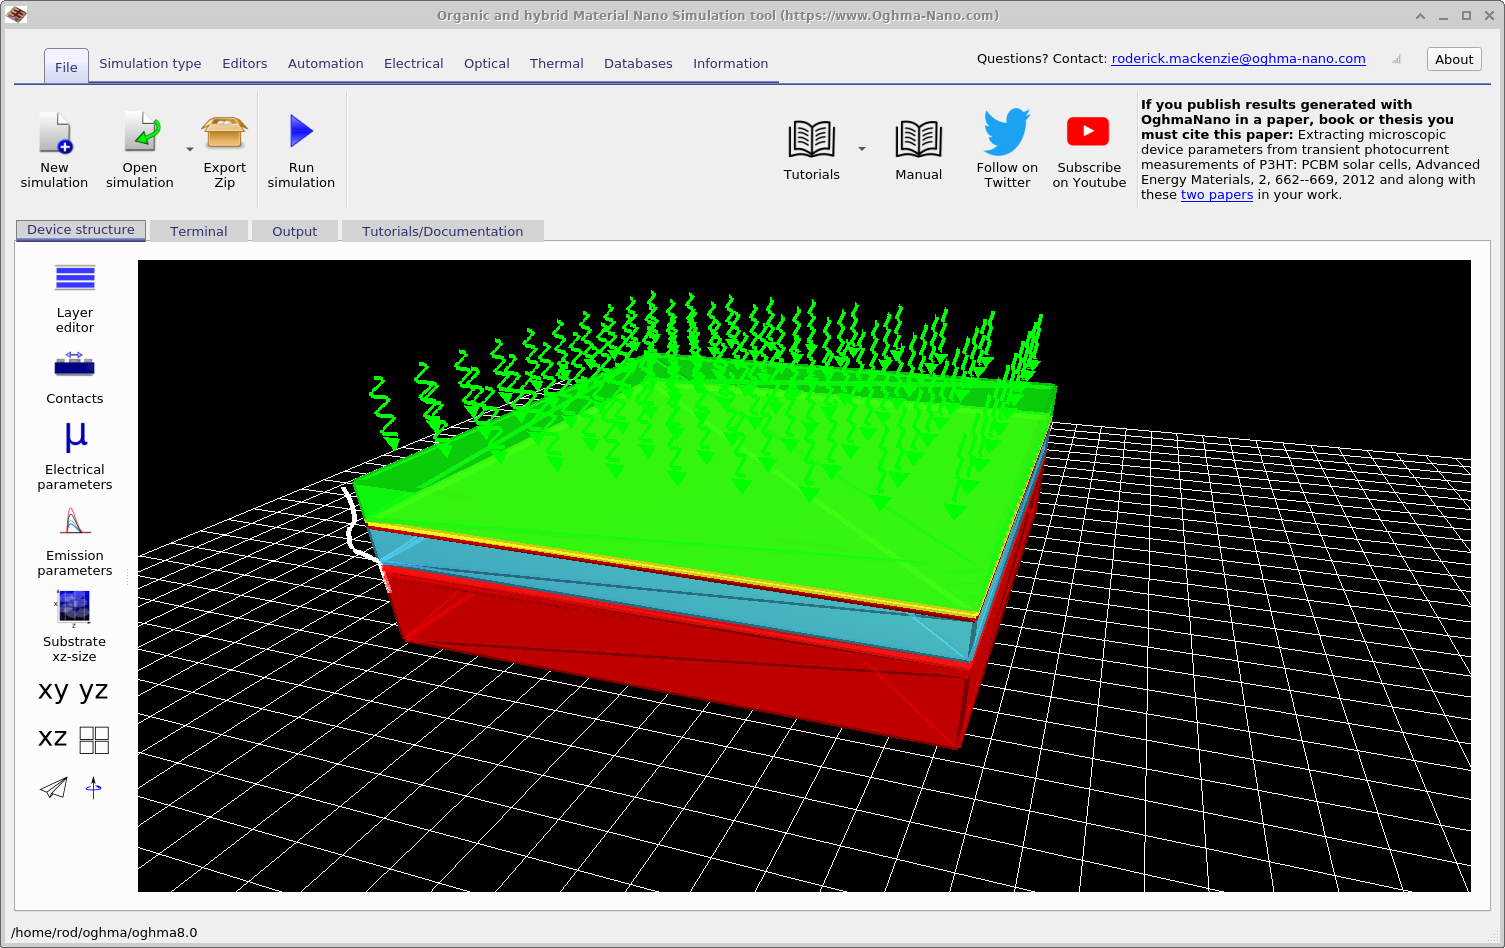
Po otwarciu przykładowej symulacji wyświetli się główne okno symulacji, jak pokazano na rysunku ??. W tym oknie przedstawiona jest w pełni skonfigurowana struktura urządzenia, która jest wykorzystywana w całym rozdziale. Na pasku narzędzi „Automatyzacja” widoczna jest ikona „Uczenie maszynowe”, oznaczona niebieskim, okrągłym symbolem. Kliknięcie tej ikony otwiera główne okno sterowania uczeniem maszynowym, jak pokazano na rysunku ??. W tym oknie można skonfigurować i uruchomić proces generowania danych treningowych dla uczenia maszynowego.
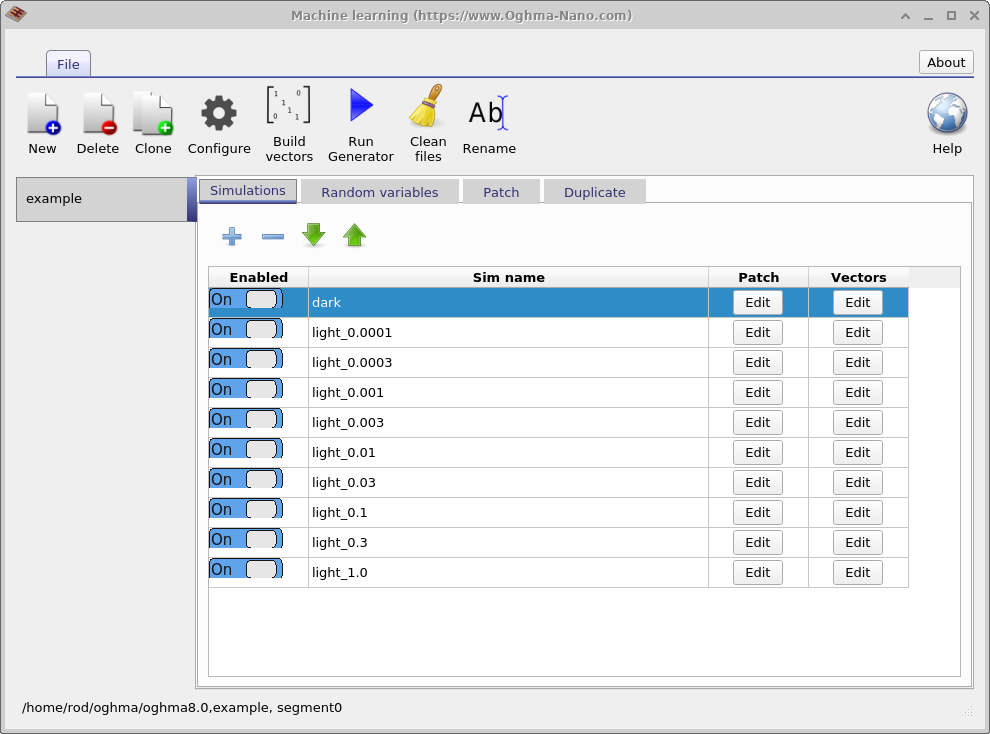
Głównym celem tego okna jest generowanie dużych zbiorów danych, które będą wykorzystywane do trenowania algorytmów uczenia maszynowego. Zbiór danych utworzony w tym przykładzie nazywa się „example”. Pierwsza wyświetlana zakładka to zakładka „Symulacje”, która definiuje zestaw symulacji przeprowadzanych dla każdego wirtualnego urządzenia. W tym przypadku symulowana jest ciemna krzywa charakterystyki ogniwa słonecznego (JV) oraz dziewięć krzywych charakterystyki ogniwa słonecznego oświetlonych światłem o natężeniu od 0,0001 do 1,0 jednostek słonecznych. Poszczególne symulacje można włączać lub wyłączać za pomocą przełącznika „Włączone”. Jeśli w kolumnie „Fragment” dla wpisu „\(light\_0.0001\)” zostanie kliknięty przycisk „Edytuj”, otworzy się okno „Fragment” wyświetlone na ilustracji ??.
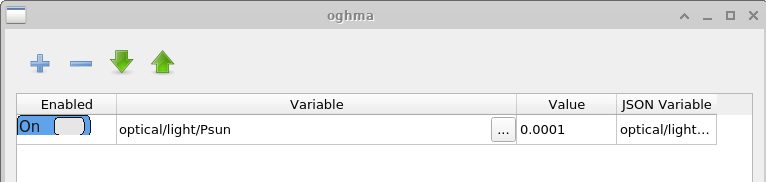
Okno „Patch” służy do modyfikowania parametrów w wirtualnej symulacji. W tym przykładzie generowanych jest wiele krzywych charakterystyk JV w różnych warunkach oświetleniowych, przy użyciu tej samej podstawowej struktury urządzenia. Aby to osiągnąć, należy niezależnie regulować natężenie światła dla każdej symulacji. Otwarcie okna „Patch” dla \(light\_0.0001\) pokazuje, że parametr symulacji „optyczny/światło/Psun”, który kontroluje natężenie oświetlenia, jest ustawiony na \(0.0001\). W przypadku symulacji w ciemności ten sam parametr jest ustawiony na \(0.0\). W ten sposób można konsekwentnie symulować wiele warunków eksperymentalnych, wykorzystując jedną podstawową symulację.
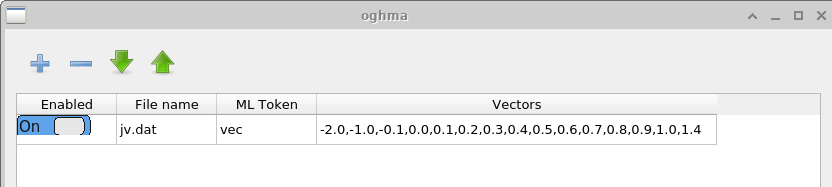
Okno „Wektory” określa, które dane są pobierane z zakończonych symulacji, aby utworzyć wektory wejściowe dla algorytmu uczenia maszynowego. W tym przykładzie z pliku \(jv.dat\), który zawiera symulowane charakterystyki prądowo-napięciowe, pobierane są punkty danych z zakresu od -2,0 V do 1,4 V. W przypadku symulacji w dziedzinie czasu użytkownik może zamiast tego pobierać dane z plików, takich jak \(time\_i.csv\) lub z dowolnego innego odpowiedniego pliku wyjściowego. Liczba punktów użytych do utworzenia każdego wektora wejściowego jest wybierana przez użytkownika. Dłuższe wektory zwiększają koszt obliczeniowy procesu uczenia, ale mogą uwzględniać bardziej szczegółowe cechy krzywej prądowo-napięciowej.
4. Definiowanie zmiennych losowych
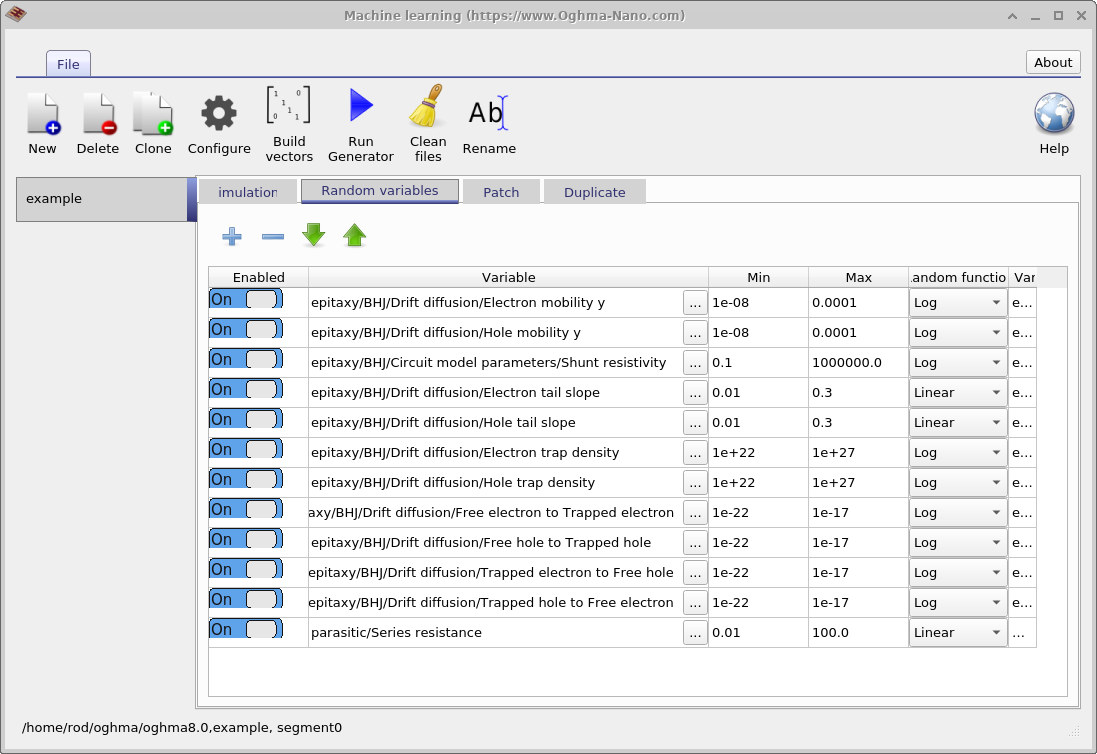
Następnym krokiem jest określenie, które parametry modelu mają być losowane. Robi się to za pomocą zakładki „Zmienne losowe” w głównym oknie programu do uczenia maszynowego. Tabela zawiera pięć kolumn. Kolumna „Włączone” określa, czy dany parametr jest uwzględniany w procesie losowania. Kolumna „Zmienna” wskazuje, który parametr symulacji jest zmieniany. Kolumny „Min” i „Max” określają dolną i górną granicę zakresu parametrów, a kolumna „Funkcja losowa” wskazuje, czy wartości są pobierane z rozkładu liniowego, czy logarytmicznego.
Rozkłady logarytmiczne są zalecane dla parametrów, których wartości zmieniają się w szerokim zakresie, natomiast rozkłady liniowe są odpowiednie dla parametrów, których wartości zmieniają się w stosunkowo wąskim zakresie. Zastosowanie rozkładu logarytmicznego zapewnia równomierne pobieranie próbek wartości, gdy są one przedstawiane w skali logarytmicznej, zamiast skupiać się na górnym końcu zakresu. Na przykład, odpowiednim parametrem liniowym byłaby energia Urbacha, która zazwyczaj zmienia się w zakresie od 30 do 150 meV. Z kolei gęstość stanów pułapek dobrze nadaje się do pobierania próbek przy użyciu rozkładu logarytmicznego, ponieważ może się zmieniać od \(1 \times 10^{15}\,\mathrm{m^{-3}}\) do \(1 \times 10^{25}\,\mathrm{m^{-3}}\).
5. Określenie liczby symulacji.
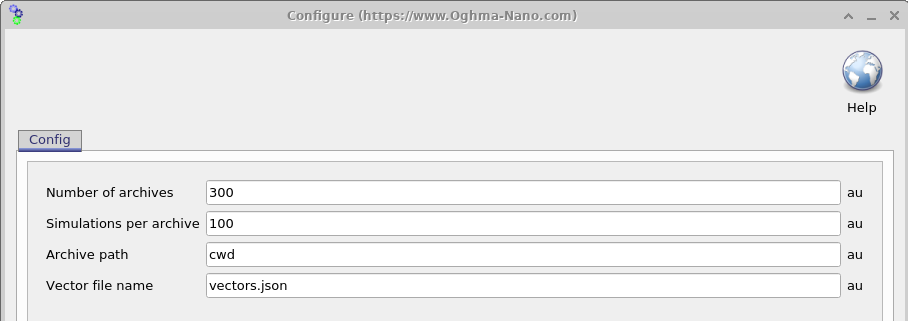
Po skonfigurowaniu symulacji kolejnym krokiem jest określenie, ile wirtualnych urządzeń z losowymi parametrami ma zostać wygenerowanych. Otwarcie okna ustawień (patrz 18.6) umożliwia kontrolowanie tego za pomocą dwóch parametrów: liczba symulacji w archiwum (\(N_{\mathrm{sim}}\)) i liczba archiwów (\(N_{\mathrm{arc}}\)). Całkowita liczba wygenerowanych wirtualnych urządzeń jest określona w \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\).
Wyniki symulacji zapisywane są w plikach ZIP, które nazywane są archiwami. Każde archiwum zawiera \(N_{\mathrm{sim}}\) wirtualnych urządzeń. W przedstawionym przykładzie generowanych i zapisywanych jest 100 plików archiwum, z których każde zawiera \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) wirtualnych urządzeń. Należy zauważyć, że w tym przykładzie każde wirtualne urządzenie składa się z jednej symulacji w warunkach braku oświetlenia oraz dziewięciu symulacji w warunkach oświetlenia. W rezultacie całkowita liczba plików wynikowych może szybko wzrosnąć.
Aby to zrealizować, generowanie danych odbywa się w partiach. OghmaNano generuje i uruchamia grupę \(N_{\mathrm{sim}}\) symulacji, a następnie zapisuje je w jednym archiwum. Proces ten jest powtarzany, aż do wygenerowania \(N_{\mathrm{arc}}\) archiwów. Takie podejście ogranicza utratę danych do aktualnie generowanego archiwum w przypadku przerwania procesu, a także upraszcza transfer plików i zwiększa odporność na uszkodzenia. Wykonywanie symulacji jest równoległe na wszystkich dostępnych rdzeniach procesora, natomiast tworzenie archiwum odbywa się na jednym rdzeniu.
6. Uruchamianie generatora zestawu danych.
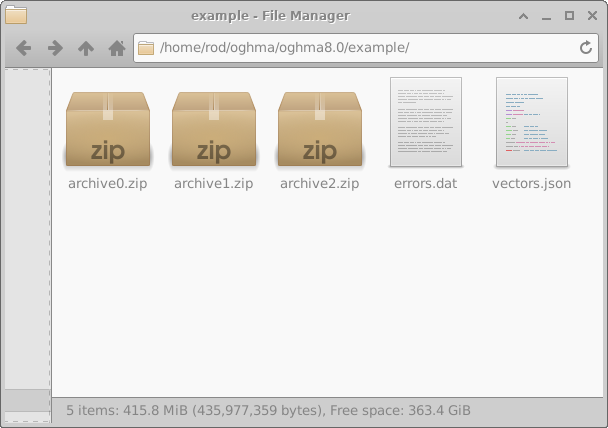
Po zakończeniu konfiguracji, naciśnięcie przycisku „Uruchom generator” w głównym oknie uczenia maszynowego (18.2) rozpoczyna proces generowania zbioru danych. Następnie OghmaNano rozpocznie wykonywanie symulacji zdefiniowanych dla każdego wirtualnego urządzenia. Po zakończeniu procesu w katalogu symulacji pojawi się katalog o nazwie „example”, jak pokazano po lewej stronie na ilustracji 18.8. W celu zilustrowania przykładu, wartość „Symulacje na archiwum” została ustawiona na 10, a wartość „Liczba archiwów” na 3, aby skrócić czas działania.
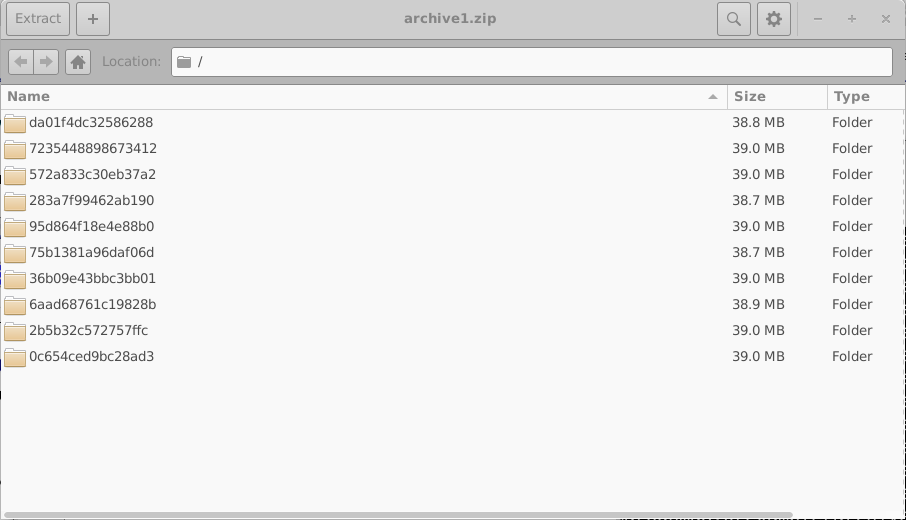
Wszelkie błędy wykryte podczas symulacji są zapisywane w pliku errors.dat. Otwarcie archiwum archive0.zip pozwala zapoznać się z wewnętrzną strukturą archiwum, co przedstawiono po prawej stronie 18.8. Każde archiwum zawiera zbiór katalogów, z których każdy odpowiada pojedynczemu wirtualnemu urządzeniu.
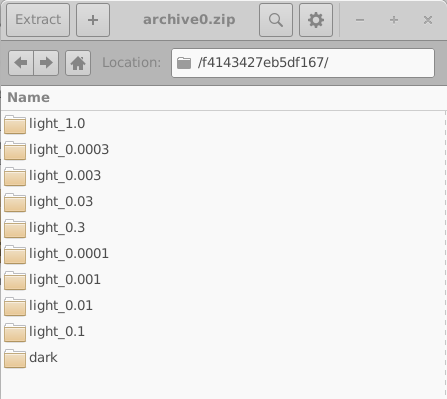
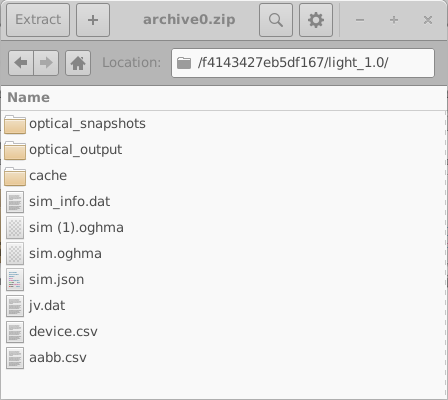
Nazwy tych katalogów są generowane losowo i składają się z 16-cyfrowych identyfikatorów szesnastkowych. Każdy katalog zawiera pełny zestaw symulacji dla jednego wirtualnego urządzenia; w tym przykładzie jest to jedna symulacja ciemnego modułu fotowoltaicznego (JV) i dziewięć symulacji oświetlonego modułu fotowoltaicznego. Zawartość jednego z takich katalogów przedstawiono po lewej stronie na ilustracji 18.10. Otwarcie pojedynczego katalogu symulacji (18.10, po prawej) ujawnia pełną symulację OghmaNano, w tym plik sim.json oraz plik jv.dat, który zawiera symulowane charakterystyki prądowo-napięciowe. Dodatkowe dane, takie jak dane dotyczące emisji światła i pliki pamięci podręcznej, również mogą się w nim znajdować.
Podczas generowania dużych zbiorów danych do uczenia maszynowego zdecydowanie zaleca się ograniczenie zbędnych danych wyjściowych, ponieważ całkowite wykorzystanie przestrzeni dyskowej może gwałtownie wzrosnąć. Można to osiągnąć, konfigurując symulację tak, aby generowała tylko niezbędne dane. Generowanie zbiorów danych odbywa się w partiach, a symulacje są wykonywane równolegle na wszystkich dostępnych rdzeniach procesora, natomiast tworzenie archiwów odbywa się na jednym rdzeniu.
W tym przykładowym przypadku tworzone są tylko trzy archiwa. W typowej sytuacji produkcyjnej tworzy się jednak zazwyczaj około 200 archiwów, z których każde zawiera około 200 wirtualnych urządzeń.
In the above example we only have three archives but in a normal simulation run one would have up to 200 archives each with 200 simulations in each.
7. Zebranie wszystkich wyników w jednym pliku.
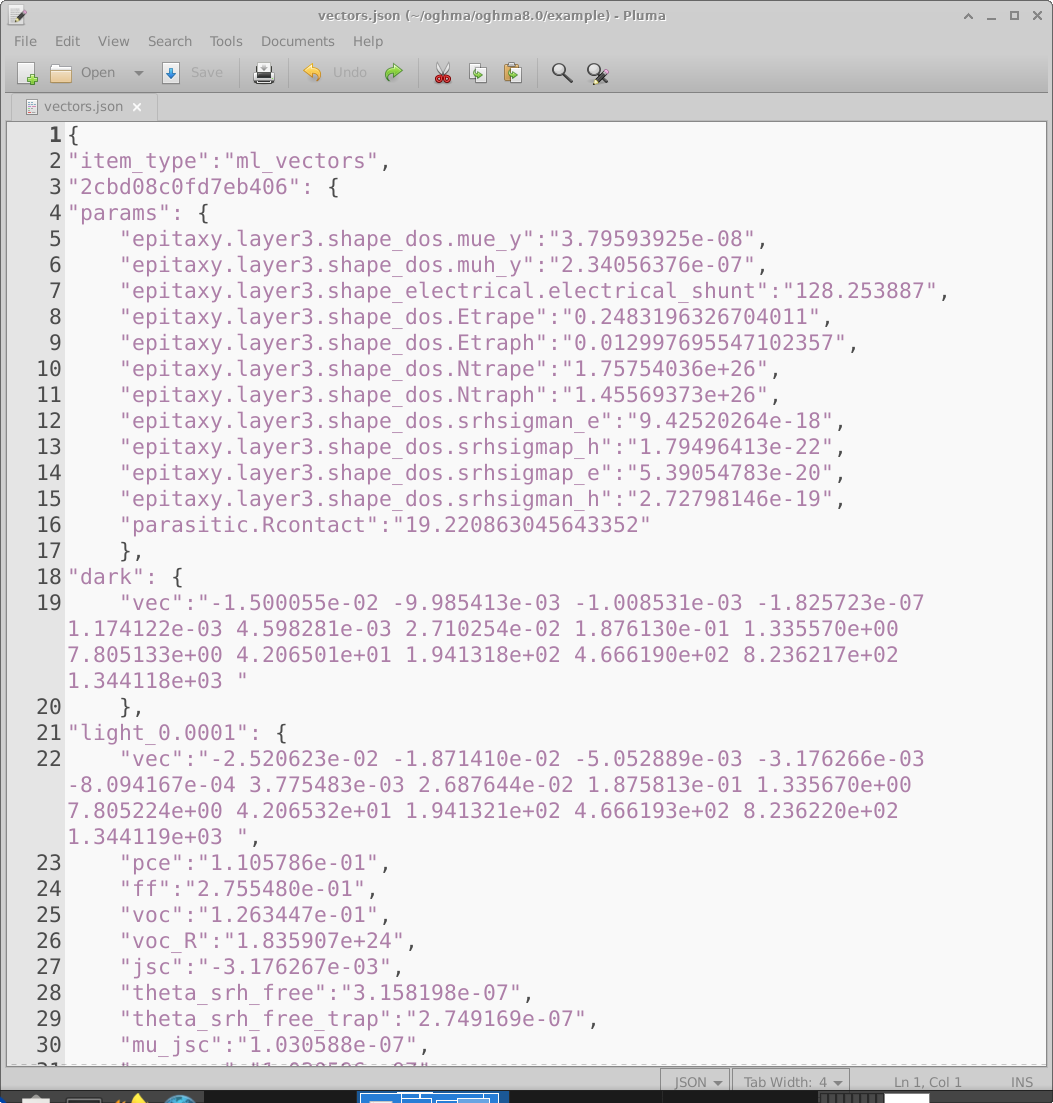
Po zakończeniu symulacji surowe dane wyjściowe OghmaNano należy przekształcić w jeden plik wektorów, który będzie odpowiedni do trenowania modelu uczenia maszynowego. Kliknięcie ikony „Utwórz wektory” w głównym oknie uczenia maszynowego (18.2) powoduje, że OghmaNano otwiera każdy wirtualny katalog urządzenia, pobiera żądane dane wyjściowe i kompiluje je w jeden plik wektorów o nazwie vectors.json. Przykład tego pliku można zobaczyć w 18.11.
Plik wektorów to dokument JSON, który zawiera wszystkie informacje niezbędne do uczenia nadzorowanego. Każde wirtualne urządzenie jest reprezentowane jako oddzielny wpis. Na przykład wpis oznaczony jako 2cbd08c0fd7eb406 (wiersz 3) zawiera w sekcji „params” losowo wybrane parametry elektryczne dla danego wirtualnego urządzenia. Następnie znajdują się w nim wyodrębnione wektory wejściowe, takie jak wektor prądu zwarciowego w ciemności (wiersz 19) i wektor prądu zwarciowego przy natężeniu oświetlenia 0,0001 Suns (wiersz 22). Jednostki liczbowe w każdym wektorze są bezpośrednio pobierane z pliku źródłowego, z którego zostały wyodrębnione. W tym przykładzie wektory pochodzą z pliku jv.dat, który przechowuje gęstość prądu \(A\,m^{-2}\) jako funkcję napięcia, więc wartości wektorów są wyrażone w \(A\,m^{-2}\). Po wektorach wejściowych, dla wygody, zapisywane są dodatkowe wartości skalarne (np. PCE).
W tym pliku będzie jeden wpis dla każdego wygenerowanego wirtualnego urządzenia. Po utworzeniu pliku vectors.json można go wykorzystać jako zbiór danych treningowych dla wybranego przez użytkownika procesu uczenia maszynowego. Niektórzy użytkownicy uważają, że łatwiej jest zaimportować dane do TensorFlow po przekonwertowaniu ich do formatu CSV; można to zrobić za pomocą standardowych bibliotek Pythona.
8. From data set to machine learning
W poprzednich sekcjach opisano, w jaki sposób OghmaNano jest wykorzystywane do tworzenia kompletnego zbioru danych do uczenia maszynowego w formacie JSON. Na tym etapie proces generowania danych jest zakończony: dla każdego wirtualnego urządzenia plik zawiera losowo wybrane parametry modelu oraz odpowiadające im wyniki symulacji, zakodowane w postaci wektorów wejściowych.
Następnym krokiem jest zaimportowanie tych danych do wybranego środowiska uczenia maszynowego. W praktyce zazwyczaj polega to na odczytaniu pliku vectors.json i przekształceniu go do formatu tabelarycznego, takiego jak CSV, który następnie można wykorzystać do trenowania, walidacji i testowania modelu. To przekształcenie można łatwo wykonać za pomocą standardowych narzędzi do tworzenia skryptów (np. Python).
Po przekształceniu dane można wykorzystać do trenowania sieci neuronowej lub innego modelu regresji, zaimplementowanego przy użyciu platformy do uczenia maszynowego, takiej jak TensorFlow, PyTorch lub podobna biblioteka. Od tego momentu wybór architektury sieci, funkcji kosztu i strategii uczenia zależy od konkretnego zastosowania i jest niezależny od OghmaNano.
W ten sposób OghmaNano zapewnia kompleksowy i zautomatyzowany proces generowania spójnych fizycznie danych treningowych, pozostawiając dalszy rozwój i optymalizację modelu uczenia maszynowego całkowicie w gestii użytkownika.