

Δημιουργία συνόλων δεδομένων για μηχανική μάθηση.
Αυτό το κεφάλαιο περιγράφει τον τρόπο δημιουργίας συνόλων δεδομένων μηχανικής μάθησης χρησιμοποιώντας το OghmaNano. Συνήθως, αυτά τα σύνολα δεδομένων εξάγονται και υποβάλλονται σε επεξεργασία χρησιμοποιώντας εξωτερικά πλαίσια, όπως το TensorFlow, για εκπαίδευση, εξαγωγή συμπερασμάτων ή πρόβλεψη.
1. Εισαγωγή
Συχνά είναι επιθυμητό να εξαχθούν φυσικές παράμετροι μιας συσκευής από πειραματικά δεδομένα μέσω μοντελοποίησης. Για παράδειγμα, μπορεί να έχουμε ένα σύνολο καμπυλών JV και να θέλουμε να προσδιορίσουμε την κινητικότητα των φορέων φορτίου και τον ρυθμό ανασύνθεσης της συσκευής. Παραδοσιακά, αυτό επιτυγχάνεται προσαρμόζοντας ένα φυσικό μοντέλο, όπως το OghmaNano, στα δεδομένα (όπως περιγράφεται στο το εκπαιδευτικό πρόγραμμα προσαρμογής). Το μειονέκτημα αυτής της προσέγγισης είναι ότι η προσαρμογή ενός μόνο συνόλου δεδομένων μπορεί να είναι χρονοβόρα και η δυσκολία αυξάνεται σημαντικά όταν πρέπει να αναλυθούν πολλαπλά σύνολα δεδομένων. Η διαδικασία προσαρμογής είναι πολύπλοκη και συνήθως απαιτεί σημαντική εμπειρία στην αριθμητική προσομοίωση και μια σημαντική ποσότητα χειροκίνητης παρέμβασης. Ως αποτέλεσμα, η λεπτομερής προσαρμογή της συσκευής πραγματοποιείται μόνο από ένα σχετικά μικρό υποσύνολο της κοινότητας.
Μια πιο σύγχρονη προσέγγιση είναι η χρήση της μηχανικής μάθησης. Αντί να προσαρμόζεται απευθείας μια ενιαία καμπύλη JV, κατασκευάζεται πρώτα μια προσομοίωση που αναπαριστά τη δομή της συσκευής. Αντί να βελτιστοποιούνται μεμονωμένες ηλεκτρικές παράμετροι, δημιουργούνται πολλές χιλιάδες αντίγραφα αυτής της συσκευής με τυχαία επιλεγμένες τιμές παραμέτρων. Κάθε μία από αυτές τις περιπτώσεις αναφέρεται ως εικονική συσκευή. Στη συνέχεια, χρησιμοποιείται ένα πρόγραμμα προσομοίωσης, όπως το OghmaNano, για να δημιουργηθούν καμπύλες JV για κάθε εικονική συσκευή, παράγοντας ένα σύνολο δεδομένων που αποτελείται από καμπύλες JV σε συνδυασμό με τις αντίστοιχες ηλεκτρικές παραμέτρους τους. Αυτά τα δεδομένα μπορούν να χρησιμοποιηθούν για την εκπαίδευση ενός μοντέλου μηχανικής μάθησης, ώστε να προβλέπει τις ηλεκτρικές παραμέτρους απευθείας από τα χαρακτηριστικά της καμπύλης JV. Σε αυτό το πλαίσιο, το OghmaNano λειτουργεί ως μια μετασχηματιστική συνάρτηση, αντιστοιχίζοντας τις ηλεκτρικές παραμέτρους σε προσομοιωμένα πειραματικά δεδομένα, ενώ το μοντέλο μηχανικής μάθησης παρέχει την αντίστροφη μετασχηματιστική συνάρτηση. Μόλις εκπαιδευτεί, το μοντέλο μπορεί να εφαρμοστεί για την εξαγωγή παραμέτρων υλικού από πραγματικές συσκευές.
Το κύριο πλεονέκτημα αυτής της προσέγγισης είναι ότι, μόλις εκπαιδευτεί, το μοντέλο μηχανικής μάθησης μπορεί να εξάγει παραμέτρους υλικών από πειραματικά δεδομένα μέσα σε δευτερόλεπτα, χωρίς να απαιτείται ο χρήστης να είναι ειδικός στις αριθμητικές προσομοιώσεις. Ωστόσο, η επιτυχία αυτής της μεθόδου εξαρτάται σε μεγάλο βαθμό από τη δημιουργία ενός μεγάλου και υψηλής ποιότητας συνόλου δεδομένων εκπαίδευσης. Η διαδικασία κατασκευής τέτοιων συνόλων δεδομένων χρησιμοποιώντας το OghmaNano περιγράφεται στις ακόλουθες σελίδες.
2. Άνοιγμα του παραδείγματος
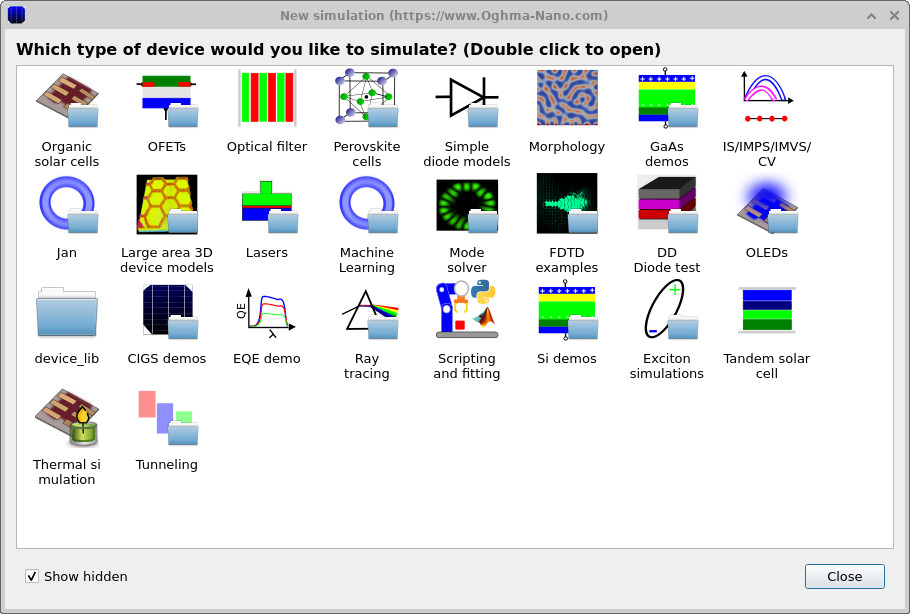
Το παράδειγμα που αναφέρεται σε αυτή τη σελίδα είναι προσβάσιμο μέσω του κουμπιού "Νέα προσομοίωση" στο κύριο παράθυρο. Αυτό ανοίγει το παράθυρο περιήγησης "Νέα προσομοίωση" που εμφανίζεται στην εικόνα ??.
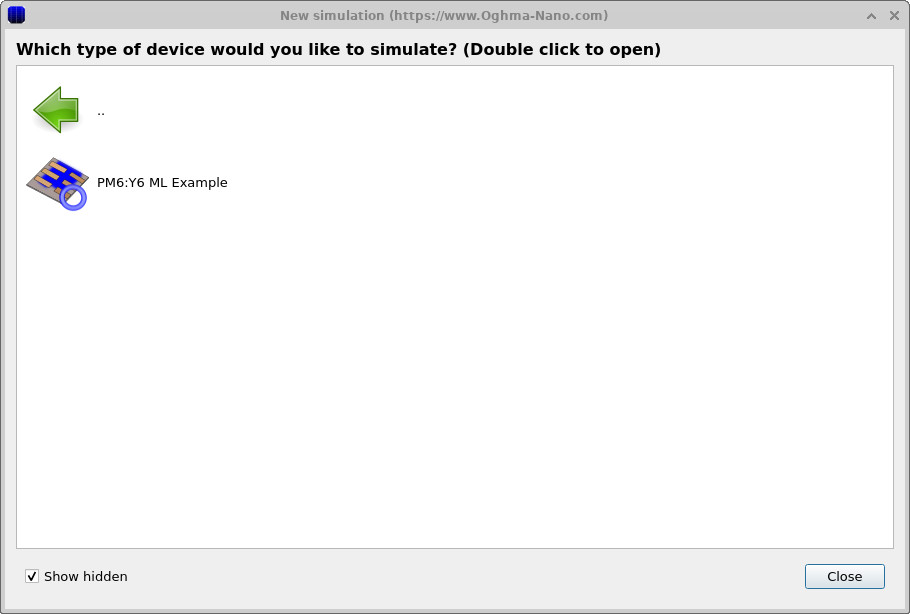
Από τη λίστα με τις διαθέσιμες κατηγορίες προσομοίωσης, κάντε διπλό κλικ στην επιλογή «Μηχανική Μάθηση» για να εμφανιστούν τα παραδείγματα μηχανικής μάθησης (??). Επιλέγοντας το παράδειγμα «PM6:Y6 ML», φορτώνεται μια προδιαμορφωμένη προσομοίωση που αντιστοιχεί στη συσκευή και τη ροή εργασίας που περιγράφονται σε αυτό το κεφάλαιο.
Μόλις ανοίξει, η προσομοίωση παρουσιάζει την ίδια δομή συσκευής και τη ρύθμιση αυτοματισμού που χρησιμοποιείται σε όλη αυτή την ενότητα και μπορεί να χρησιμοποιηθεί απευθείας για τη δημιουργία δεδομένων εκπαίδευσης μηχανικής μάθησης χωρίς περαιτέρω διαμόρφωση.
3. Ορισμός των προσομοιώσεων και των διανυσμάτων εξόδου.
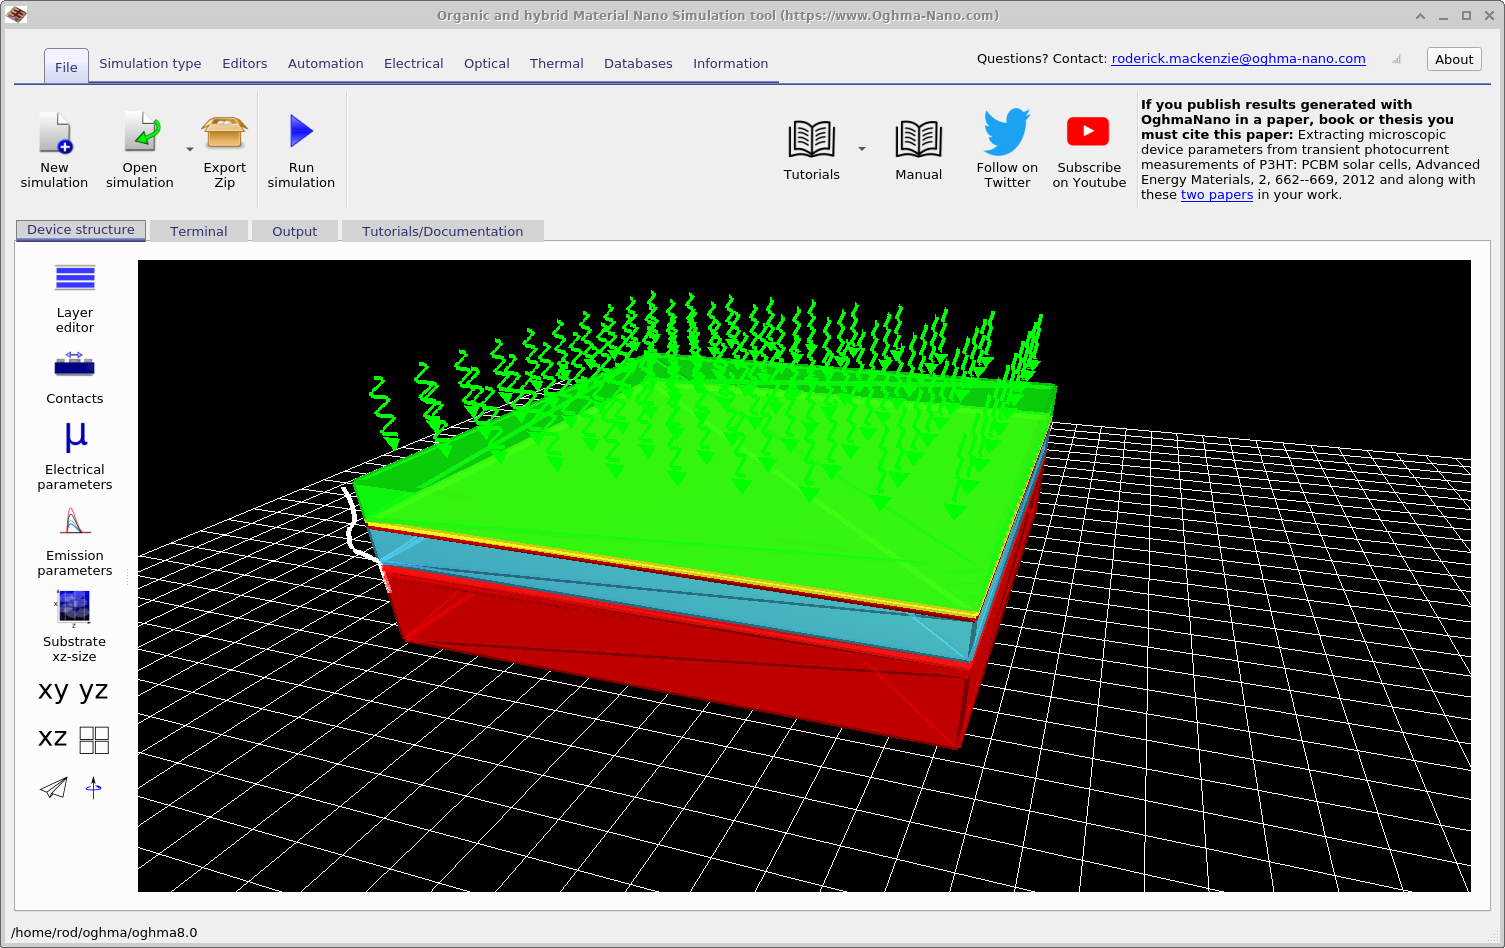
Αφού ανοίξετε το παράδειγμα προσομοίωσης, θα εμφανιστεί το κύριο παράθυρο προσομοίωσης, όπως φαίνεται στην Εικόνα ??. Αυτό το παράθυρο εμφανίζει την πλήρως διαμορφωμένη δομή της συσκευής που χρησιμοποιείται σε όλο αυτό το κεφάλαιο. Στην κορδέλα Αυτοματισμού, είναι ορατό ένα εικονίδιο Μηχανικής Μάθησης, το οποίο απεικονίζεται με ένα μπλε κυκλικό σύμβολο. Κάνοντας κλικ σε αυτό το εικονίδιο, ανοίγει το κύριο παράθυρο ελέγχου μηχανικής μάθησης, όπως φαίνεται στην Εικόνα ??. Από αυτό το παράθυρο, διαμορφώνεται και εκτελείται η δημιουργία δεδομένων εκπαίδευσης μηχανικής μάθησης.
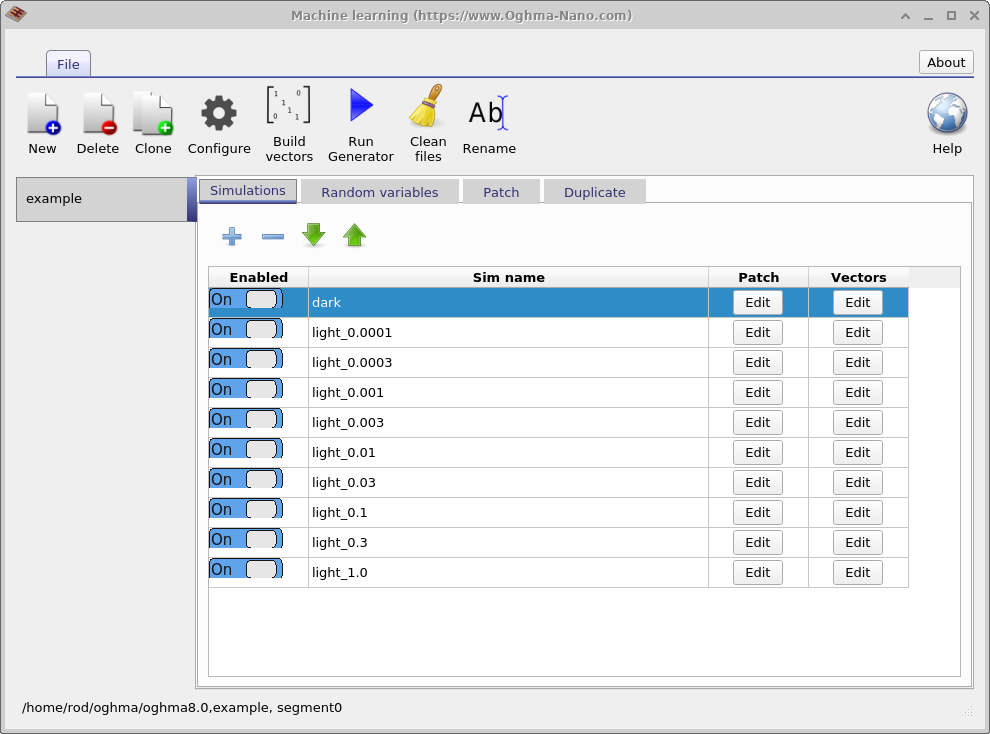
Ο κύριος σκοπός αυτού του παραθύρου είναι η δημιουργία μεγάλων συνόλων δεδομένων για την εκπαίδευση αλγορίθμων μηχανικής μάθησης. Το σύνολο δεδομένων που παράγεται σε αυτό το παράδειγμα ονομάζεται «example». Η πρώτη καρτέλα που εμφανίζεται είναι η καρτέλα «Simulations», η οποία ορίζει το σύνολο των προσομοιώσεων που εκτελούνται για κάθε εικονική συσκευή. Σε αυτήν την περίπτωση, προσομοιώνεται μια σκοτεινή καμπύλη JV και εννέα φωτεινές καμπύλες JV, με εντάσεις φωτός που κυμαίνονται από 0,0001 Suns έως 1,0 Suns. Οι μεμονωμένες προσομοιώσεις μπορούν να ενεργοποιηθούν ή να απενεργοποιηθούν χρησιμοποιώντας την επιλογή «Enabled». Εάν κάνετε κλικ στο κουμπί «Edit» στη στήλη «Patch» για την καταχώρηση \(light\_0.0001\), ανοίγει το παράθυρο «Patch» που εμφανίζεται στην ??.
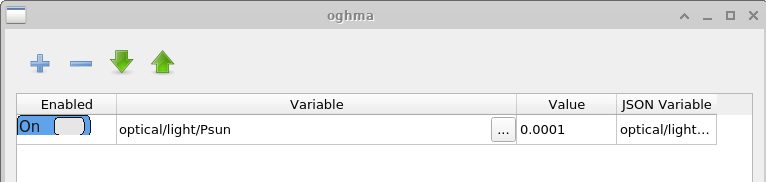
Ο σκοπός του παραθύρου Patch είναι η τροποποίηση παραμέτρων εντός μιας εικονικής προσομοίωσης. Σε αυτό το παράδειγμα, δημιουργούνται πολλαπλές καμπύλες JV (ρεύματος-τάσης) υπό διαφορετικές συνθήκες φωτισμού, χρησιμοποιώντας την ίδια βασική δομή συσκευής. Για να επιτευχθεί αυτό, η ένταση του φωτός πρέπει να ρυθμίζεται ανεξάρτητα για κάθε προσομοίωση. Το άνοιγμα του παραθύρου Patch για το \(light\_0.0001\) δείχνει ότι η παράμετρος προσομοίωσης optical/light/Psun, η οποία ελέγχει την ένταση του φωτισμού, έχει οριστεί σε \(0.0001\). Για την προσομοίωση στο σκοτάδι, η ίδια παράμετρος έχει οριστεί σε \(0.0\). Με αυτόν τον τρόπο, μπορούν να προσομοιωθούν με συνέπεια πολλαπλές πειραματικές συνθήκες χρησιμοποιώντας μια ενιαία βασική προσομοίωση.
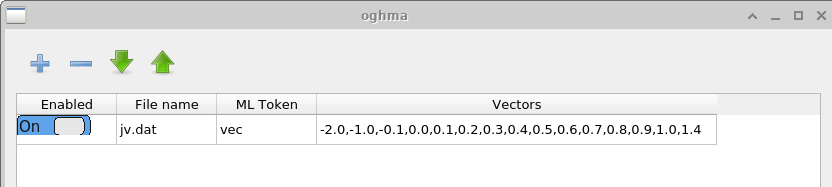
Το παράθυρο "Vectors" καθορίζει ποια δεδομένα εξάγονται από τις ολοκληρωμένες προσομοιώσεις για να σχηματίσουν τα διανύσματα εισόδου για την εκπαίδευση του μοντέλου μηχανικής μάθησης. Σε αυτό το παράδειγμα, δεδομένα μεταξύ -2,0 V και 1,4 V εξάγονται από το αρχείο \(jv.dat\), το οποίο περιέχει τα προσομοιωμένα χαρακτηριστικά ρεύματος-τάσης. Για προσομοιώσεις στον τομέα του χρόνου, ο χρήστης μπορεί να επιλέξει να εξάγει δεδομένα από αρχεία όπως το \(time\_i.csv\) ή οποιοδήποτε άλλο κατάλληλο αρχείο εξόδου. Ο αριθμός των σημείων που χρησιμοποιούνται για τη δημιουργία κάθε διανύσματος εισόδου καθορίζεται από τον χρήστη. Μεγαλύτερα διανύσματα αυξάνουν το υπολογιστικό κόστος της εκπαίδευσης, αλλά μπορεί να αποτυπώσουν πιο λεπτομερείς πτυχές της καμπύλης ρεύματος-τάσης.
4. Ορισμός των τυχαίων μεταβλητών
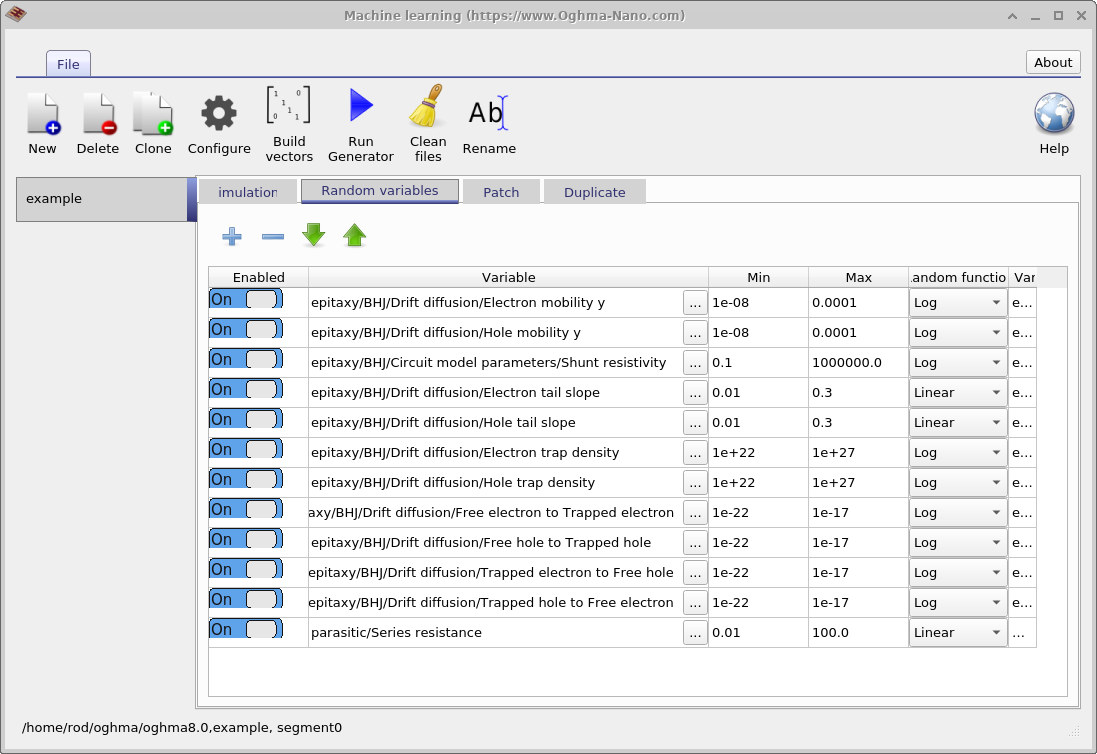
Το επόμενο βήμα είναι να καθοριστούν οι παράμετροι του μοντέλου που θα υποστούν τυχαιοποίηση. Αυτό γίνεται χρησιμοποιώντας την καρτέλα «Τυχαίες μεταβλητές» στο κύριο παράθυρο μηχανικής μάθησης. Ο πίνακας περιέχει πέντε στήλες. Η στήλη «Ενεργοποιημένο» καθορίζει εάν μια παράμετρος περιλαμβάνεται στη διαδικασία τυχαιοποίησης. Η στήλη «Μεταβλητή» καθορίζει ποια παράμετρος προσομοίωσης μεταβάλλεται. Οι στήλες «Ελάχιστη» και «Μέγιστη» ορίζουν τα κατώτερα και ανώτερα όρια του εύρους της παραμέτρου, και η στήλη «Τυχαία συνάρτηση» καθορίζει εάν οι τιμές προέρχονται από μια γραμμική ή λογαριθμική κατανομή.
Οι λογαριθμικές κατανομές συνιστώνται για παραμέτρους που καλύπτουν πολλαπλές τάξεις μεγέθους, ενώ οι γραμμικές κατανομές είναι κατάλληλες για παραμέτρους που μεταβάλλονται σε ένα σχετικά στενό εύρος. Η χρήση μιας λογαριθμικής κατανομής διασφαλίζει ότι οι τιμές δειγματοληπτούνται ομοιόμορφα όταν εξετάζονται σε μια λογαριθμική κλίμακα, αντί να συγκεντρώνονται προς το ανώτερο άκρο του εύρους. Για παράδειγμα, μια κατάλληλη γραμμική παράμετρος θα ήταν η ενέργεια Urbach, η οποία συνήθως κυμαίνεται μεταξύ 30 και 150 meV. Αντίθετα, οι πυκνότητες παγίδων είναι κατάλληλες για λογαριθμική δειγματοληψία, καθώς μπορεί να κυμαίνονται από \(1 \times 10^{15}\,\mathrm{m^{-3}}\) έως \(1 \times 10^{25}\,\mathrm{m^{-3}}\).
5. Καθορισμός του αριθμού των προσομοιώσεων.
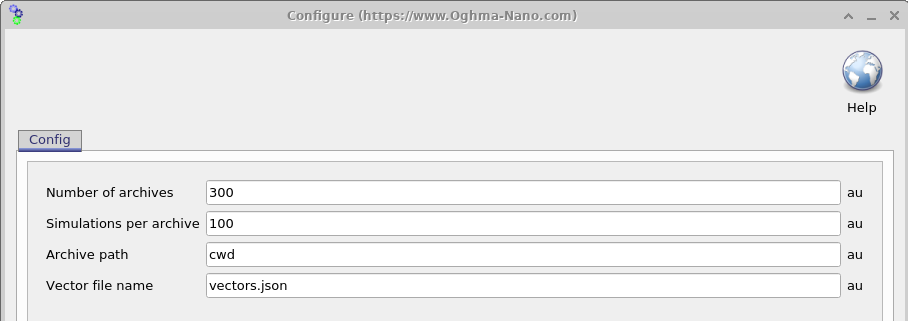
Αφού διαμορφωθεί η προσομοίωση, το επόμενο βήμα είναι να καθοριστεί ο αριθμός των εικονικών συσκευών με τυχαίες παραμέτρους που θα δημιουργηθούν. Ανοίγοντας το παράθυρο Ρυθμίσεων (δείτε 18.6), μπορείτε να ελέγξετε αυτό χρησιμοποιώντας δύο παραμέτρους: Προσομοιώσεις ανά αρχείο (\(N_{\mathrm{sim}}\)) και Αριθμός αρχείων (\(N_{\mathrm{arc}}\)). Ο συνολικός αριθμός των εικονικών συσκευών που δημιουργούνται δίνεται από την εξίσωση \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\).
Τα αποτελέσματα της προσομοίωσης αποθηκεύονται σε αρχεία ZIP, τα οποία ονομάζονται αρχεία, και κάθε αρχείο περιέχει \(N_{\mathrm{sim}}\) εικονικές συσκευές. Στο παράδειγμα που παρουσιάζεται εδώ, δημιουργούνται και αποθηκεύονται 100 αρχεία, καθένα από τα οποία περιέχει \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) εικονικές συσκευές. Είναι σημαντικό να σημειωθεί ότι, σε αυτό το παράδειγμα, κάθε εικονική συσκευή αποτελείται από μία προσομοίωση σκοτεινής φωτοβολταϊκής κυψέλης και εννέα προσομοιώσεις φωτεινής φωτοβολταϊκής κυψέλης. Ως αποτέλεσμα, ο συνολικός αριθμός των αρχείων εξόδου μπορεί να αυξηθεί γρήγορα.
Για να διαχειριστούμε αυτό, η δημιουργία δεδομένων γίνεται σε παρτίδες. Μια ομάδα \(N_{\mathrm{sim}}\) προσομοιώσεων δημιουργείται και εκτελείται από το OghmaNano, στη συνέχεια αποθηκεύεται σε ένα ενιαίο αρχείο και αυτή η διαδικασία επαναλαμβάνεται μέχρι να δημιουργηθούν \(N_{\mathrm{arc}}\) αρχεία. Αυτή η προσέγγιση περιορίζει την απώλεια δεδομένων στο αρχείο που δημιουργείται αυτήν τη στιγμή, σε περίπτωση διακοπής της διαδικασίας, και επίσης απλοποιεί τη μεταφορά αρχείων και βελτιώνει την ανθεκτικότητα έναντι πιθανών σφαλμάτων. Η εκτέλεση των προσομοιώσεων γίνεται παράλληλα σε όλους τους διαθέσιμους πυρήνες της CPU, ενώ η δημιουργία των αρχείων γίνεται σε έναν μόνο πυρήνα.
6. Εκτέλεση του προγράμματος δημιουργίας του συνόλου δεδομένων.
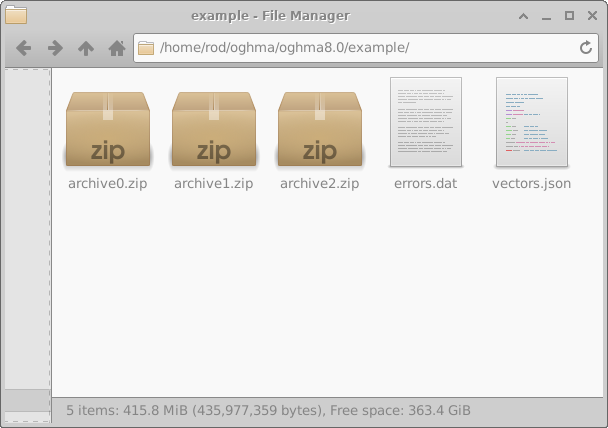
Μόλις ολοκληρωθεί η διαμόρφωση, πατώντας το κουμπί "Εκτέλεση δημιουργού" στο κύριο παράθυρο της Μηχανικής Μάθησης (18.2), ξεκινά η διαδικασία δημιουργίας του συνόλου δεδομένων. Το OghmaNano θα ξεκινήσει στη συνέχεια την εκτέλεση των προσομοιώσεων που έχουν οριστεί για κάθε εικονική συσκευή. Όταν ολοκληρωθεί η διαδικασία, θα εμφανιστεί ένας φάκελος με το όνομα "example" στον φάκελο προσομοίωσης, όπως φαίνεται στην αριστερή πλευρά του 18.8. Για τους σκοπούς αυτού του παραδείγματος, οι "Προσομοιώσεις ανά αρχείο" ορίστηκαν σε 10 και ο "Αριθμός αρχείων" ορίστηκε σε 3, προκειμένου να μειωθεί ο χρόνος εκτέλεσης.
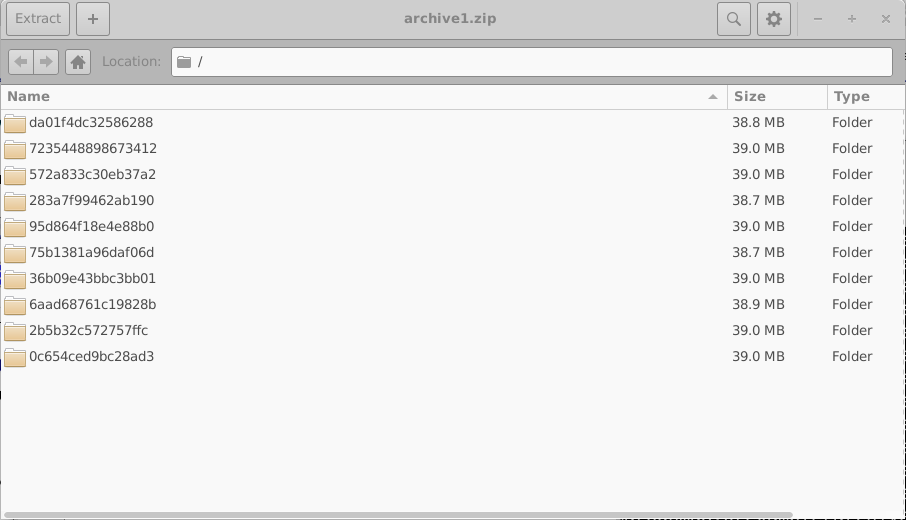
Οποιαδήποτε σφάλματα εντοπιστούν κατά τη διάρκεια της προσομοίωσης καταγράφονται στο αρχείο errors.dat. Ανοίγοντας το archive0.zip, αποκαλύπτεται η εσωτερική δομή ενός αρχείου, η οποία εμφανίζεται στην δεξιά πλευρά του 18.8. Κάθε αρχείο περιέχει μια συλλογή καταλόγων, καθένας από τους οποίους αντιστοιχεί σε μια μεμονωμένη εικονική συσκευή.
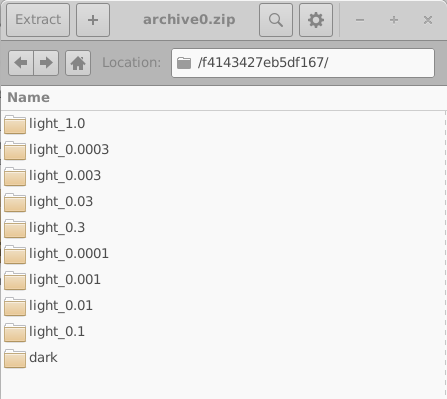
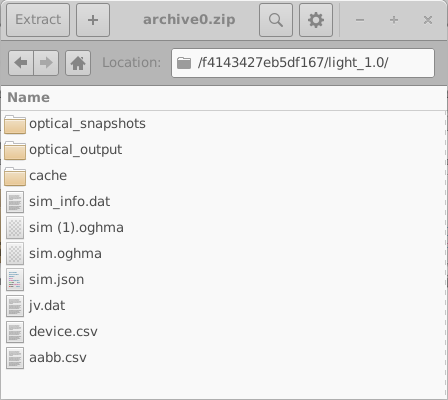
Αυτοί οι φάκελοι έχουν ονόματα που δημιουργούνται χρησιμοποιώντας τυχαίους δεκαεξαδικούς αναγνωριστικούς 16 ψηφίων. Κάθε φάκελος περιέχει το πλήρες σύνολο των προσομοιώσεων για μία εικονική συσκευή· σε αυτό το παράδειγμα, μία προσομοίωση σκοτεινής JV και εννέα προσομοιώσεις φωτεινής JV. Το περιεχόμενο ενός τέτοιου φακέλου εμφανίζεται στην αριστερή πλευρά του 18.10. Ανοίγοντας έναν μεμονωμένο φάκελο προσομοίωσης (18.10, δεξιά), αποκαλύπτεται μια πλήρης προσομοίωση OghmaNano, συμπεριλαμβανομένου του αρχείου sim.json και του αρχείου jv.dat που περιέχει τα προσομοιωμένα χαρακτηριστικά ρεύματος-τάσης. Μπορεί επίσης να υπάρχουν επιπλέον δεδομένα, όπως οπτικές έξοδοι και αρχεία προσωρινής αποθήκευσης.
Κατά τη δημιουργία μεγάλων συνόλων δεδομένων για μηχανική μάθηση, συνιστάται ιδιαίτερα να ελαχιστοποιείται η περιττή έξοδος, καθώς η συνολική χρήση του δίσκου μπορεί να αυξηθεί ραγδαία. Αυτό μπορεί να επιτευχθεί διαμορφώνοντας την προσομοίωση ώστε να παράγει μόνο τα απαραίτητα δεδομένα εξόδου. Η δημιουργία συνόλων δεδομένων πραγματοποιείται σε παρτίδες, με τις προσομοιώσεις να εκτελούνται παράλληλα σε όλους τους διαθέσιμους πυρήνες της CPU, ενώ η δημιουργία αρχείων γίνεται σε έναν μόνο πυρήνα.
Σε αυτό το ενδεικτικό παράδειγμα, δημιουργούνται μόνο τρία αρχεία. Ωστόσο, σε μια τυπική παραγωγική διαδικασία, είναι συνηθισμένο να δημιουργούνται περίπου 200 αρχεία, καθένα από τα οποία περιέχει περίπου 200 εικονικές συσκευές.
In the above example we only have three archives but in a normal simulation run one would have up to 200 archives each with 200 simulations in each.
7. Συγκέντρωση των αποτελεσμάτων σε ένα ενιαίο αρχείο.
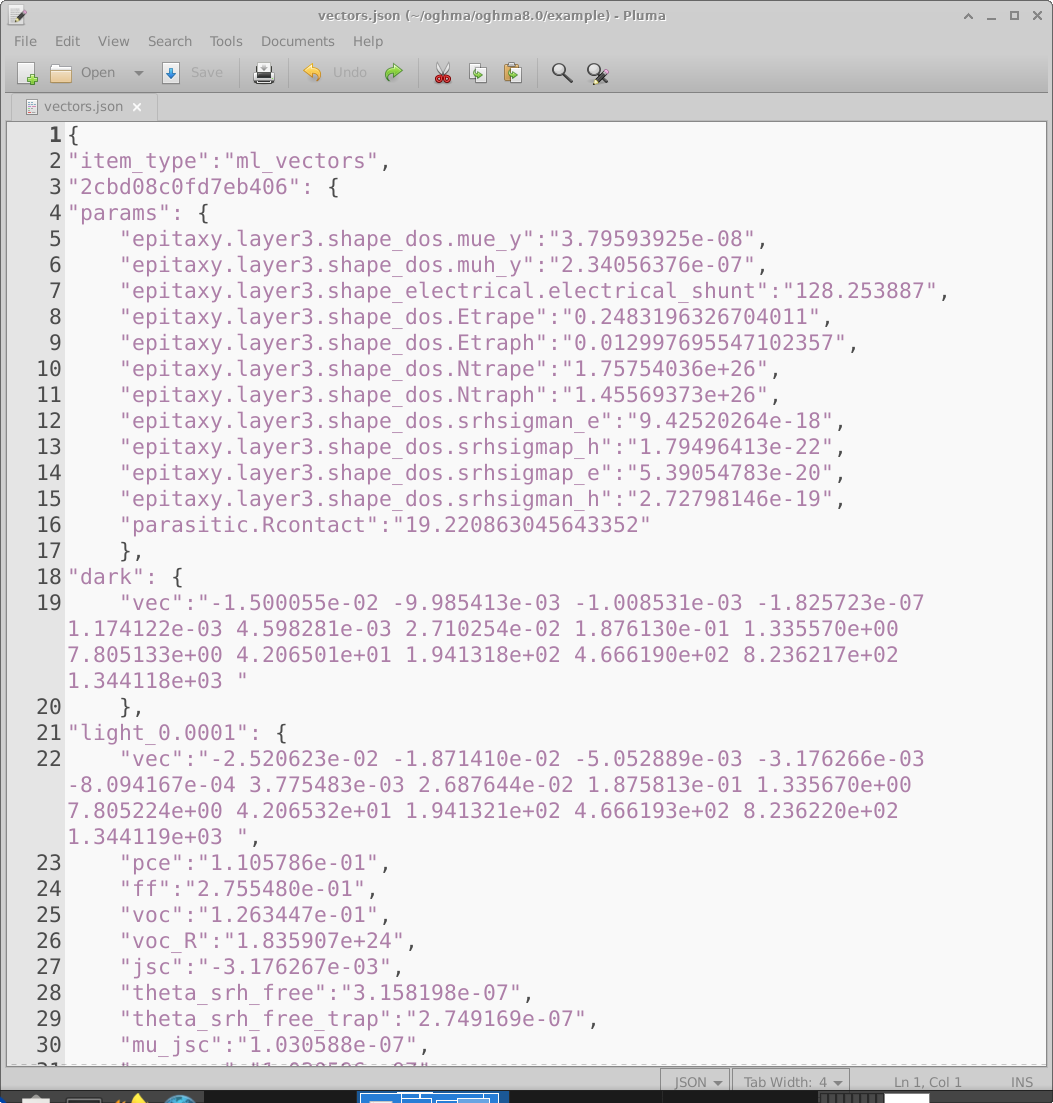
Μόλις ολοκληρωθούν οι προσομοιώσεις, η ακατέργαστη έξοδος του OghmaNano πρέπει να μετατραπεί σε ένα ενιαίο αρχείο διανυσμάτων, κατάλληλο για την εκπαίδευση ενός μοντέλου μηχανικής μάθησης. Κάνοντας κλικ στο εικονίδιο "Δημιουργία διανυσμάτων" στο κύριο παράθυρο της Μηχανικής Μάθησης (18.2), το OghmaNano ανοίγει κάθε κατάλογο εικονικής συσκευής, εξάγει τις απαιτούμενες εξόδους και τις συντάσσει σε ένα ενιαίο αρχείο vectors.json. Ένα παράδειγμα αυτού του αρχείου εμφανίζεται στο 18.11.
Το αρχείο διανυσμάτων είναι ένα έγγραφο JSON που περιέχει όλες τις πληροφορίες που απαιτούνται για την εποπτευόμενη μάθηση. Κάθε εικονική συσκευή εμφανίζεται ως ξεχωριστή εγγραφή. Για παράδειγμα, η εγγραφή με την ετικέτα 2cbd08c0fd7eb406 (γραμμή 3) περιέχει, στην ενότητα "params", τις ηλεκτρικές παραμέτρους που επιλέχθηκαν τυχαία για αυτήν την εικονική συσκευή. Ακολουθούν τα εξαγόμενα διανύσματα εισόδου, όπως το διανυσματικό στοιχείο σκοτεινής καμπύλης I-V (γραμμή 19) και το διανυσματικό στοιχείο καμπύλης I-V υπό φωτισμό στις 0,0001 Suns (γραμμή 22). Οι αριθμητικές μονάδες σε κάθε διάνυσμα προέρχονται απευθείας από το αρχείο προέλευσης από το οποίο εξάγονται. Σε αυτό το παράδειγμα, τα διανύσματα προέρχονται από το jv.dat, το οποίο αποθηκεύει την πυκνότητα ρεύματος σε \(A\,m^{-2}\) ως συνάρτηση της τάσης, επομένως οι τιμές του διανύσματος είναι σε \(A\,m^{-2}\). Μετά τα διανύσματα εισόδου, αποθηκεύονται επιπλέον αριθμητικές έξοδοι (για παράδειγμα, PCE) για λόγους ευκολίας.
Σε αυτό το αρχείο θα υπάρχει μία εγγραφή για κάθε εικονική συσκευή που δημιουργείται. Αφού δημιουργηθεί το αρχείο vectors.json, μπορεί να χρησιμοποιηθεί ως το σύνολο δεδομένων εκπαίδευσης για τη ροή εργασίας μηχανικής μάθησης που επιθυμείτε. Ορισμένοι χρήστες διαπιστώνουν ότι είναι ευκολότερο να εισαγάγουν τα δεδομένα στο TensorFlow αφού τα μετατρέψουν σε μορφή CSV. Αυτό μπορεί να γίνει χρησιμοποιώντας τις τυπικές βιβλιοθήκες της Python.
8. From data set to machine learning
Οι προηγούμενες ενότητες περιγράφουν πώς το OghmaNano χρησιμοποιείται για τη δημιουργία ενός πλήρους συνόλου δεδομένων μηχανικής μάθησης σε μορφή JSON. Σε αυτό το σημείο, η διαδικασία δημιουργίας δεδομένων ολοκληρώνεται: για κάθε εικονική συσκευή, το αρχείο περιέχει τις τυχαία επιλεγμένες παραμέτρους του μοντέλου, μαζί με τις αντίστοιχες εξόδους της προσομοίωσης, οι οποίες είναι κωδικοποιημένες ως διανύσματα εισόδου.
Το επόμενο βήμα είναι η εισαγωγή αυτών των δεδομένων σε ένα πλαίσιο μηχανικής μάθησης της επιλογής σας. Στην πράξη, αυτό συνήθως περιλαμβάνει την ανάγνωση του αρχείου vectors.json και τη μετατροπή του σε μια μορφή πίνακα, όπως το CSV, η οποία στη συνέχεια μπορεί να χρησιμοποιηθεί για εκπαίδευση, επικύρωση και δοκιμή. Αυτή η μετατροπή μπορεί να πραγματοποιηθεί εύκολα χρησιμοποιώντας τυπικά εργαλεία δημιουργίας σεναρίων (για παράδειγμα, Python).
Μόλις μετατραπούν, τα δεδομένα μπορούν να χρησιμοποιηθούν για την εκπαίδευση ενός νευρωνικού δικτύου ή άλλου μοντέλου παλινδρόμησης, το οποίο υλοποιείται χρησιμοποιώντας ένα πλαίσιο μηχανικής μάθησης, όπως το TensorFlow, το PyTorch ή μια παρόμοια βιβλιοθήκη. Από αυτό το σημείο και έπειτα, η επιλογή της αρχιτεκτονικής του δικτύου, της συνάρτησης απώλειας και της στρατηγικής εκπαίδευσης εξαρτάται από την συγκεκριμένη εφαρμογή και είναι ανεξάρτητη από το OghmaNano.
Με αυτόν τον τρόπο, η OghmaNano παρέχει μια ολοκληρωμένη και αυτοματοποιημένη διαδικασία για τη δημιουργία δεδομένων εκπαίδευσης που είναι φυσικά συνεπή, αφήνοντας την επακόλουθη ανάπτυξη και βελτιστοποίηση του μοντέλου μηχανικής μάθησης εξ ολοκλήρου υπό τον έλεγχο του χρήστη.