

Creazione di set di dati per l’apprendimento automaticoCreazione di set di dati per l’apprendimento automatico
Questo capitolo descrive come creare set di dati per l’apprendimento automatico utilizzando OghmaNano. In genere, questi set di dati vengono esportati ed elaborati utilizzando framework esterni come TensorFlow per l’addestramento, l’inferenza o la previsione.Questo capitolo descrive come creare set di dati per l’apprendimento automatico utilizzando OghmaNano. In genere, questi set di dati vengono esportati ed elaborati utilizzando framework esterni come TensorFlow per l’addestramento, l’inferenza o la previsione.
1. Introduzione1. Introduzione
Spesso è utile ricavare i parametri fisici di un dispositivo dai dati sperimentali mediante la modellazione. Ad esempio, si potrebbe avere una serie di curve corrente-tensione (JV) e voler determinare la mobilità dei portatori di carica e il tasso di ricombinazione del dispositivo. Tradizionalmente, questo si ottiene adattando un modello basato sulla fisica, come OghmaNano, ai dati (come descritto in il tutorial sull'adattamento). Lo svantaggio di questo approccio è che l'adattamento di un singolo set di dati può richiedere molto tempo e la difficoltà aumenta notevolmente quando è necessario analizzare più set di dati. Il processo di adattamento è complesso e richiede in genere una notevole competenza nella simulazione numerica e un considerevole intervento manuale. Di conseguenza, l'adattamento dettagliato del dispositivo viene eseguito solo da una ristretta parte della comunità.Spesso è utile ricavare i parametri fisici di un dispositivo dai dati sperimentali mediante la modellazione. Ad esempio, si potrebbe avere una serie di curve corrente-tensione (JV) e voler determinare la mobilità dei portatori di carica e il tasso di ricombinazione del dispositivo. Tradizionalmente, questo si ottiene adattando un modello basato sulla fisica, come OghmaNano, ai dati (come descritto in il tutorial sull'adattamento). Lo svantaggio di questo approccio è che l'adattamento di un singolo set di dati può richiedere molto tempo e la difficoltà aumenta notevolmente quando è necessario analizzare più set di dati. Il processo di adattamento è complesso e richiede in genere una notevole competenza nella simulazione numerica e un considerevole intervento manuale. Di conseguenza, l'adattamento dettagliato del dispositivo viene eseguito solo da una ristretta parte della comunità.
Un approccio più moderno consiste nell’utilizzare l’apprendimento automatico. Invece di adattare direttamente una singola curva JV, si crea innanzitutto una simulazione che rappresenta la struttura del dispositivo. Anziché ottimizzare singoli parametri elettrici, vengono generate molte migliaia di copie di questo dispositivo, con valori di parametri selezionati in modo casuale. Ciascuna di queste istanze viene definita come un dispositivo virtuale. Viene quindi utilizzato un programma di simulazione, come OghmaNano, per generare curve JV per ciascun dispositivo virtuale, producendo un set di dati costituito da curve JV associate ai rispettivi parametri elettrici. Questi dati possono essere utilizzati per addestrare un modello di apprendimento automatico in grado di prevedere i parametri elettrici direttamente dalle caratteristiche della curva JV. In questo contesto, OghmaNano funge da trasformazione diretta, mappando i parametri elettrici sui dati sperimentali simulati, mentre il modello di apprendimento automatico fornisce la trasformazione inversa. Una volta addestrato, il modello può essere applicato per estrarre i parametri dei materiali da dispositivi reali.Un approccio più moderno consiste nell’utilizzare l’apprendimento automatico. Invece di adattare direttamente una singola curva JV, si crea innanzitutto una simulazione che rappresenta la struttura del dispositivo. Anziché ottimizzare singoli parametri elettrici, vengono generate molte migliaia di copie di questo dispositivo, con valori di parametri selezionati in modo casuale. Ciascuna di queste istanze viene definita come un dispositivo virtuale. Viene quindi utilizzato un programma di simulazione, come OghmaNano, per generare curve JV per ciascun dispositivo virtuale, producendo un set di dati costituito da curve JV associate ai rispettivi parametri elettrici. Questi dati possono essere utilizzati per addestrare un modello di apprendimento automatico in grado di prevedere i parametri elettrici direttamente dalle caratteristiche della curva JV. In questo contesto, OghmaNano funge da trasformazione diretta, mappando i parametri elettrici sui dati sperimentali simulati, mentre il modello di apprendimento automatico fornisce la trasformazione inversa. Una volta addestrato, il modello può essere applicato per estrarre i parametri dei materiali da dispositivi reali.
Il principale vantaggio di questo approccio è che, una volta addestrato, il modello di apprendimento automatico può estrarre i parametri dei materiali dai dati sperimentali in pochi secondi, senza richiedere all’utente di essere un esperto in simulazioni numeriche. Tuttavia, il successo di questo metodo dipende in modo cruciale dalla creazione di un ampio set di dati di addestramento di alta qualità. Il processo di creazione di tali set di dati utilizzando OghmaNano è descritto nelle pagine seguenti.Il principale vantaggio di questo approccio è che, una volta addestrato, il modello di apprendimento automatico può estrarre i parametri dei materiali dai dati sperimentali in pochi secondi, senza richiedere all’utente di essere un esperto in simulazioni numeriche. Tuttavia, il successo di questo metodo dipende in modo cruciale dalla creazione di un ampio set di dati di addestramento di alta qualità. Il processo di creazione di tali set di dati utilizzando OghmaNano è descritto nelle pagine seguenti.
2. Apertura dell’esempio2. Apertura dell’esempio
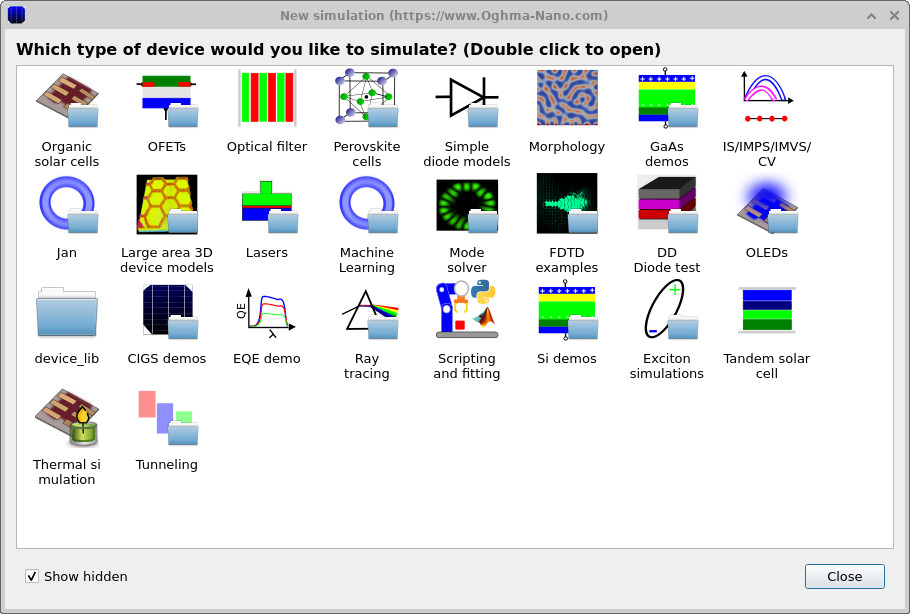
L’esempio di cui si parla in questa pagina è accessibile tramite il pulsante «Nuova simulazione» nella finestra principale. Cliccando su questo pulsante si apre la finestra di dialogo «Nuova simulazione» mostrata in ??.L’esempio di cui si parla in questa pagina è accessibile tramite il pulsante «Nuova simulazione» nella finestra principale. Cliccando su questo pulsante si apre la finestra di dialogo «Nuova simulazione» mostrata in ??.
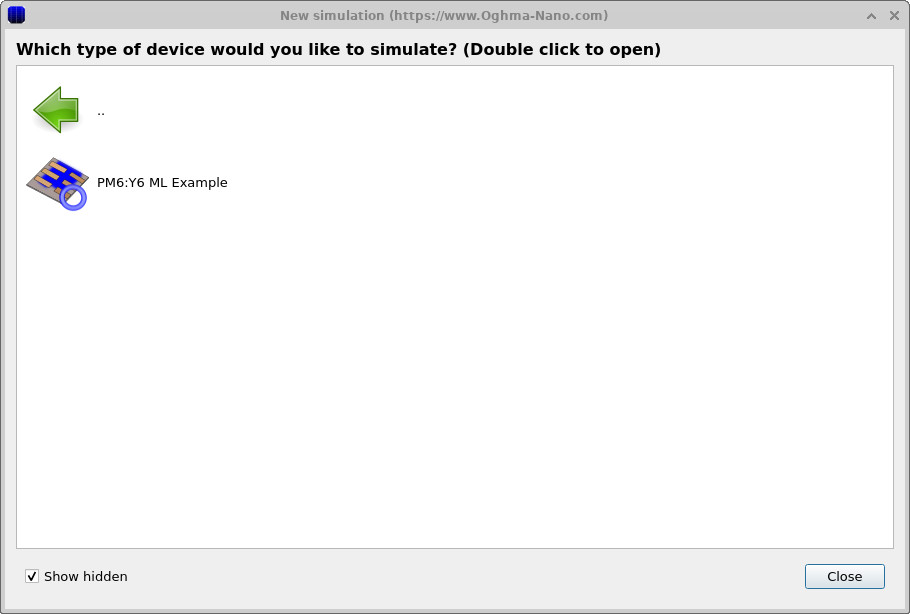
Dall’elenco delle categorie di simulazione disponibili, fate doppio clic su «Apprendimento automatico» per visualizzare gli esempi relativi all’apprendimento automatico (??). Selezionando l’esempio PM6:Y6 ML, si avvia una simulazione preconfigurata che corrisponde al dispositivo e al flusso di lavoro descritti in questo capitolo.Dall’elenco delle categorie di simulazione disponibili, fate doppio clic su «Apprendimento automatico» per visualizzare gli esempi relativi all’apprendimento automatico (??). Selezionando l’esempio PM6:Y6 ML, si avvia una simulazione preconfigurata che corrisponde al dispositivo e al flusso di lavoro descritti in questo capitolo.
Una volta avviata, la simulazione presenta la stessa struttura del dispositivo e la stessa configurazione di automazione utilizzate in tutta questa sezione e può essere utilizzata direttamente per generare dati di addestramento per l’apprendimento automatico, senza la necessità di ulteriori configurazioni.Una volta avviata, la simulazione presenta la stessa struttura del dispositivo e la stessa configurazione di automazione utilizzate in tutta questa sezione e può essere utilizzata direttamente per generare dati di addestramento per l’apprendimento automatico, senza la necessità di ulteriori configurazioni.
3. Definizione delle simulazioni e dei vettori di output3. Definizione delle simulazioni e dei vettori di output
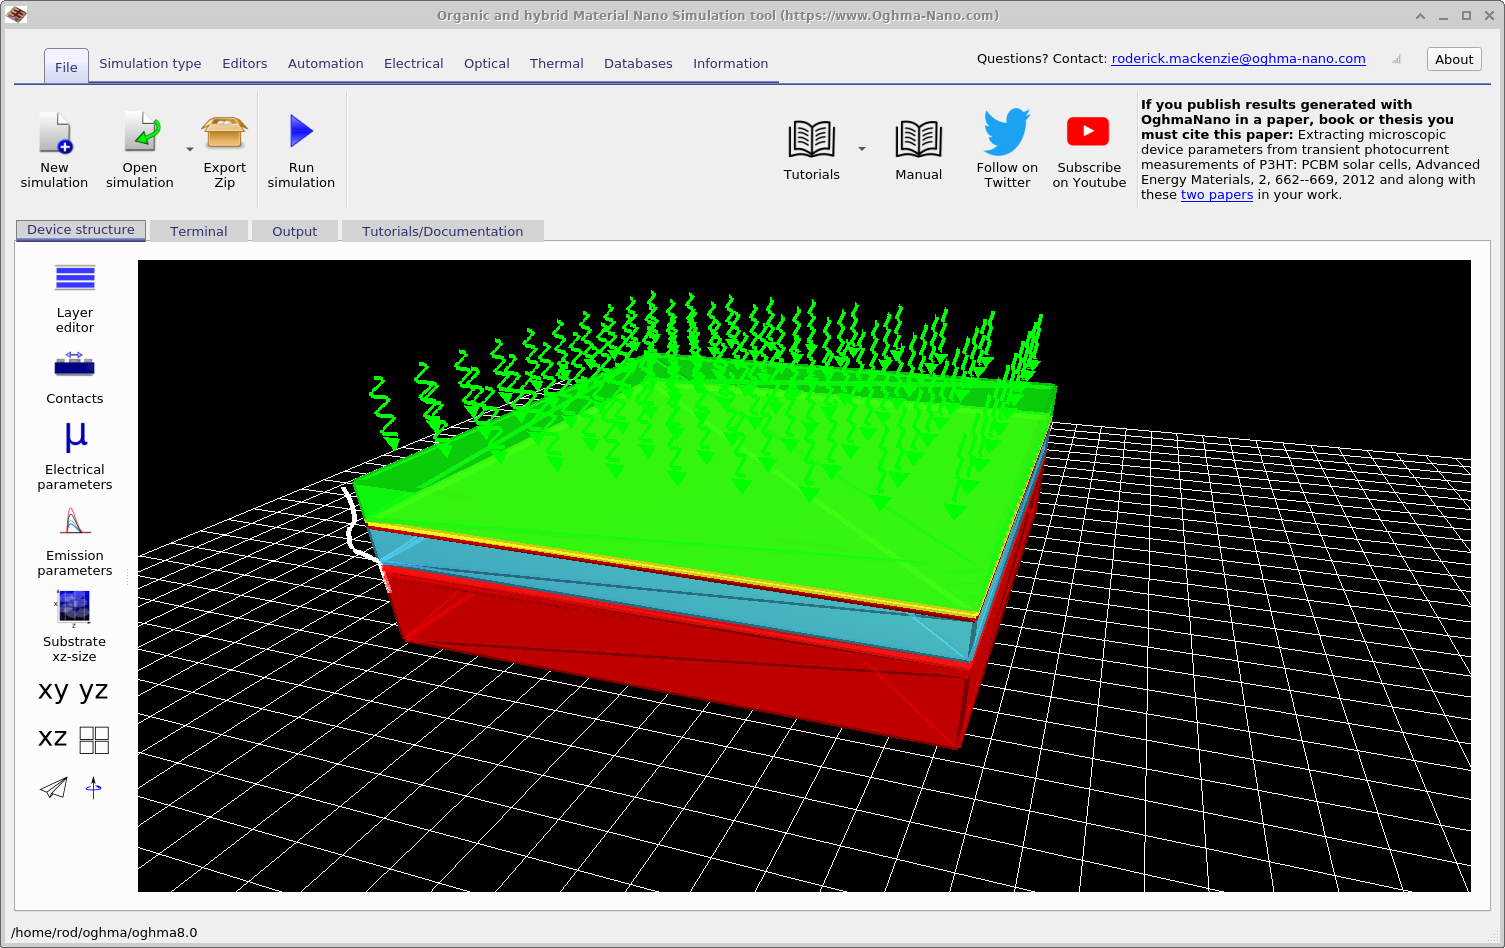
Una volta aperta la simulazione di esempio, verrà visualizzata la finestra principale della simulazione, come illustrato nella figura ??. Questa finestra mostra la struttura del dispositivo completamente configurata, utilizzata in tutto il capitolo. Nella barra multifunzione «Automazione», è visibile un’icona relativa all’apprendimento automatico, rappresentata da un simbolo circolare blu. Cliccando su questa icona, si apre la finestra principale di controllo dell’apprendimento automatico, illustrata nella figura ??. Da questa finestra è possibile configurare ed eseguire la generazione dei dati di addestramento per l’apprendimento automatico.Una volta aperta la simulazione di esempio, verrà visualizzata la finestra principale della simulazione, come illustrato nella figura ??. Questa finestra mostra la struttura del dispositivo completamente configurata, utilizzata in tutto il capitolo. Nella barra multifunzione «Automazione», è visibile un’icona relativa all’apprendimento automatico, rappresentata da un simbolo circolare blu. Cliccando su questa icona, si apre la finestra principale di controllo dell’apprendimento automatico, illustrata nella figura ??. Da questa finestra è possibile configurare ed eseguire la generazione dei dati di addestramento per l’apprendimento automatico.
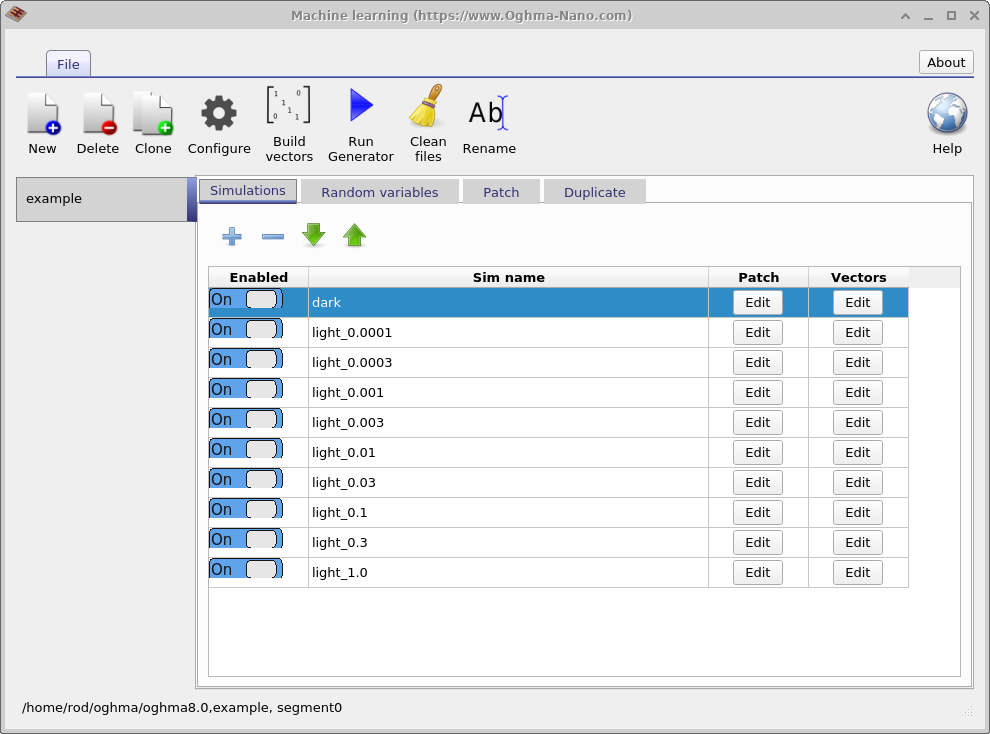
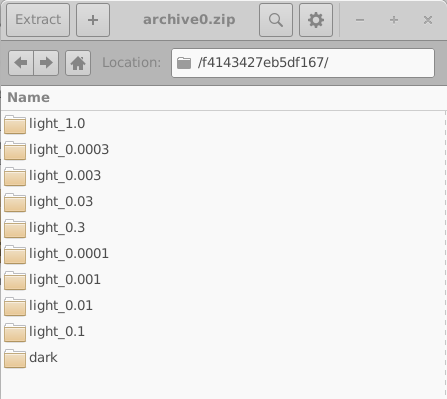
Lo scopo principale di questa finestra è generare grandi quantità di dati per l’addestramento di algoritmi di apprendimento automatico. Il set di dati prodotto in questo esempio è denominato «example». La prima scheda visualizzata è la scheda «Simulazioni», che definisce l’insieme di simulazioni eseguite per ciascun dispositivo virtuale. In questo caso, viene simulata una curva JV in condizioni di oscurità e nove curve JV in condizioni di illuminazione, con intensità luminose che variano da 0,0001 Suns a 1,0 Suns. Le singole simulazioni possono essere attivate o disattivate utilizzando l’interruttore «Abilitato». Se si fa clic sul pulsante «Modifica» nella colonna «Patch» per la voce «\(light\_0.0001\)», si apre la finestra «Patch» mostrata in «??».Lo scopo principale di questa finestra è generare grandi quantità di dati per l’addestramento di algoritmi di apprendimento automatico. Il set di dati prodotto in questo esempio è denominato «example». La prima scheda visualizzata è la scheda «Simulazioni», che definisce l’insieme di simulazioni eseguite per ciascun dispositivo virtuale. In questo caso, viene simulata una curva JV in condizioni di oscurità e nove curve JV in condizioni di illuminazione, con intensità luminose che variano da 0,0001 Suns a 1,0 Suns. Le singole simulazioni possono essere attivate o disattivate utilizzando l’interruttore «Abilitato». Se si fa clic sul pulsante «Modifica» nella colonna «Patch» per la voce «\(light\_0.0001\)», si apre la finestra «Patch» mostrata in «??».
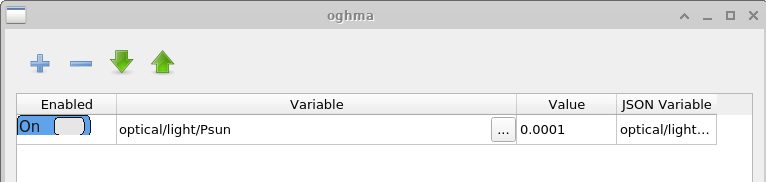
La funzione della finestra «Patch» è quella di modificare i parametri all’interno di una simulazione virtuale. In questo esempio, vengono generate diverse curve JV in condizioni di illuminazione differenti, utilizzando la stessa struttura di base del dispositivo. Per ottenere questo risultato, l’intensità della luce deve essere regolata in modo indipendente per ciascuna simulazione. Aprendo la finestra «Patch» per \(light\_0.0001\), si può vedere che il parametro di simulazione ottico/luce/Psun, che controlla l’intensità dell’illuminazione, è impostato su \(0.0001\). Per la simulazione in condizioni di oscurità, lo stesso parametro è impostato su \(0.0\). In questo modo, è possibile simulare in modo coerente diverse condizioni sperimentali utilizzando una singola simulazione di base.La funzione della finestra «Patch» è quella di modificare i parametri all’interno di una simulazione virtuale. In questo esempio, vengono generate diverse curve JV in condizioni di illuminazione differenti, utilizzando la stessa struttura di base del dispositivo. Per ottenere questo risultato, l’intensità della luce deve essere regolata in modo indipendente per ciascuna simulazione. Aprendo la finestra «Patch» per \(light\_0.0001\), si può vedere che il parametro di simulazione ottico/luce/Psun, che controlla l’intensità dell’illuminazione, è impostato su \(0.0001\). Per la simulazione in condizioni di oscurità, lo stesso parametro è impostato su \(0.0\). In questo modo, è possibile simulare in modo coerente diverse condizioni sperimentali utilizzando una singola simulazione di base.
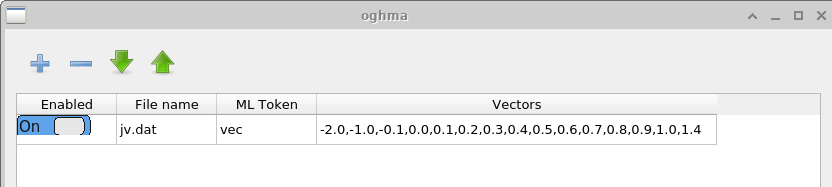
La finestra Vettori definisce quali dati vengono estratti dalle simulazioni completate per creare i vettori di input utilizzati per l’apprendimento automatico. In questo esempio, i punti dati compresi tra -2,0 V e 1,4 V vengono estratti dal file \(jv.dat\), che contiene le caratteristiche simulate corrente-tensione. Per le simulazioni nel dominio del tempo, l’utente può invece estrarre i dati da file come \(time\_i.csv\) o da qualsiasi altro file di output appropriato. Il numero di punti utilizzati per creare ciascun vettore di input viene scelto dall’utente. Vettori più lunghi aumentano il costo computazionale dell’addestramento, ma possono acquisire caratteristiche più dettagliate della curva corrente-tensione.La finestra Vettori definisce quali dati vengono estratti dalle simulazioni completate per creare i vettori di input utilizzati per l’apprendimento automatico. In questo esempio, i punti dati compresi tra -2,0 V e 1,4 V vengono estratti dal file \(jv.dat\), che contiene le caratteristiche simulate corrente-tensione. Per le simulazioni nel dominio del tempo, l’utente può invece estrarre i dati da file come \(time\_i.csv\) o da qualsiasi altro file di output appropriato. Il numero di punti utilizzati per creare ciascun vettore di input viene scelto dall’utente. Vettori più lunghi aumentano il costo computazionale dell’addestramento, ma possono acquisire caratteristiche più dettagliate della curva corrente-tensione.
4. Definizione delle variabili aleatorie4. Definizione delle variabili aleatorie
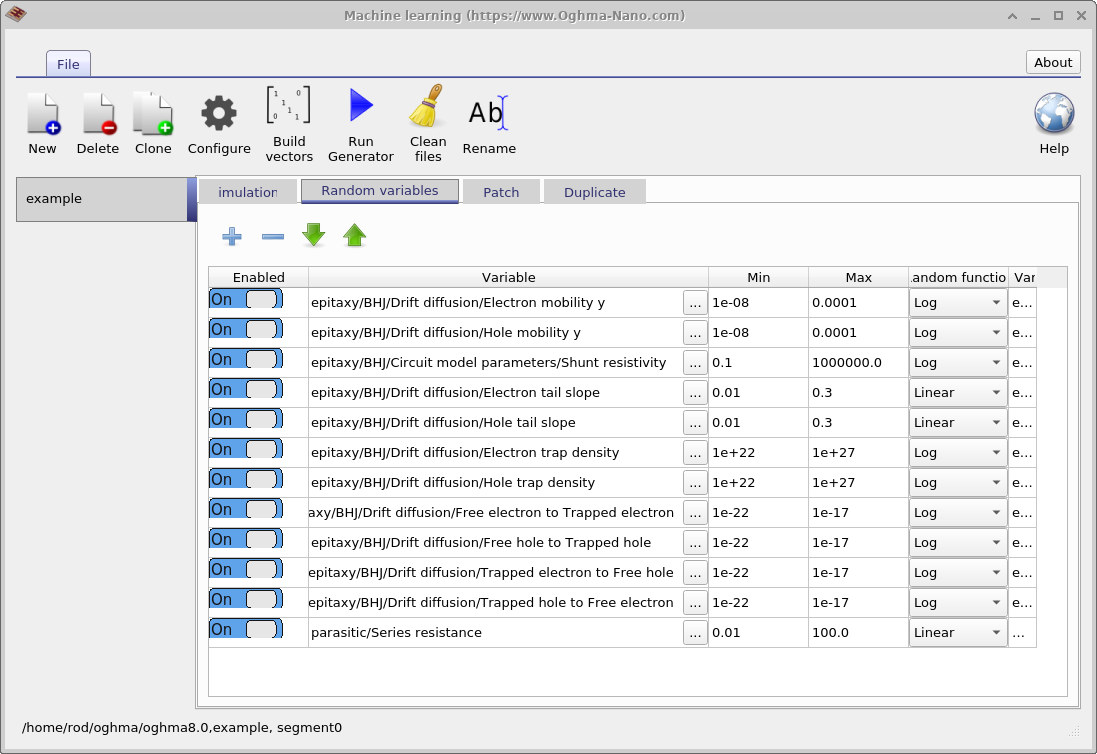
Il passo successivo consiste nel definire quali parametri del modello devono essere sottoposti a randomizzazione. Questa operazione si esegue utilizzando la scheda «Variabili casuali» nella finestra principale dell’applicazione di machine learning. La tabella contiene cinque colonne. La colonna «Abilitato» indica se un parametro è incluso nel processo di randomizzazione. La colonna «Variabile» specifica quale parametro della simulazione viene modificato. Le colonne «Min» e «Max» definiscono i valori minimo e massimo dell’intervallo del parametro, mentre la colonna «Funzione casuale» indica se i valori vengono estratti da una distribuzione lineare o logaritmica.Il passo successivo consiste nel definire quali parametri del modello devono essere sottoposti a randomizzazione. Questa operazione si esegue utilizzando la scheda «Variabili casuali» nella finestra principale dell’applicazione di machine learning. La tabella contiene cinque colonne. La colonna «Abilitato» indica se un parametro è incluso nel processo di randomizzazione. La colonna «Variabile» specifica quale parametro della simulazione viene modificato. Le colonne «Min» e «Max» definiscono i valori minimo e massimo dell’intervallo del parametro, mentre la colonna «Funzione casuale» indica se i valori vengono estratti da una distribuzione lineare o logaritmica.
Si raccomandano le distribuzioni logaritmiche per i parametri che coprono diversi ordini di grandezza, mentre le distribuzioni lineari sono più adatte per i parametri che variano in un intervallo relativamente ristretto. L’utilizzo di una distribuzione logaritmica garantisce che i valori siano campionati in modo uniforme quando vengono visualizzati su una scala logaritmica, anziché essere raggruppati verso l’estremità superiore dell’intervallo. Ad esempio, un parametro lineare appropriato potrebbe essere l’energia di Urbach, che in genere varia tra 30 e 150 meV. Al contrario, le densità di trappola si adattano bene al campionamento logaritmico, poiché possono variare da \(1 \times 10^{15}\,\mathrm{m^{-3}}\) a \(1 \times 10^{25}\,\mathrm{m^{-3}}\).Si raccomandano le distribuzioni logaritmiche per i parametri che coprono diversi ordini di grandezza, mentre le distribuzioni lineari sono più adatte per i parametri che variano in un intervallo relativamente ristretto. L’utilizzo di una distribuzione logaritmica garantisce che i valori siano campionati in modo uniforme quando vengono visualizzati su una scala logaritmica, anziché essere raggruppati verso l’estremità superiore dell’intervallo. Ad esempio, un parametro lineare appropriato potrebbe essere l’energia di Urbach, che in genere varia tra 30 e 150 meV. Al contrario, le densità di trappola si adattano bene al campionamento logaritmico, poiché possono variare da \(1 \times 10^{15}\,\mathrm{m^{-3}}\) a \(1 \times 10^{25}\,\mathrm{m^{-3}}\).
5. Definizione del numero di simulazioni5. Definizione del numero di simulazioni
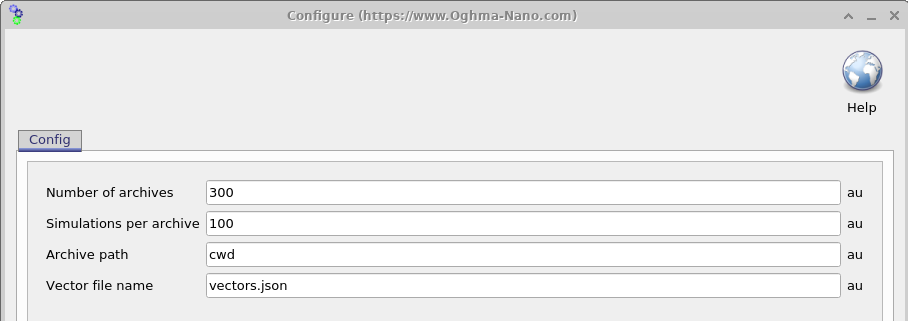
Una volta configurata la simulazione, il passo successivo consiste nel determinare quanti dispositivi virtuali con parametri casuali devono essere generati. Aprendo la finestra delle impostazioni (vedere 18.6), è possibile controllare questo aspetto utilizzando due parametri: numero di simulazioni per archivio (\(N_{\mathrm{sim}}\)) e numero di archivi (\(N_{\mathrm{arc}}\)). Il numero totale di dispositivi virtuali generati è indicato in \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\).Una volta configurata la simulazione, il passo successivo consiste nel determinare quanti dispositivi virtuali con parametri casuali devono essere generati. Aprendo la finestra delle impostazioni (vedere 18.6), è possibile controllare questo aspetto utilizzando due parametri: numero di simulazioni per archivio (\(N_{\mathrm{sim}}\)) e numero di archivi (\(N_{\mathrm{arc}}\)). Il numero totale di dispositivi virtuali generati è indicato in \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\).
I risultati della simulazione vengono salvati in file ZIP, denominati archivi, e ogni archivio contiene \(N_{\mathrm{sim}}\) dispositivi virtuali. Nell’esempio mostrato, vengono generati e salvati 100 archivi, ciascuno dei quali contiene \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) dispositivi virtuali. È importante notare che, in questo esempio, ogni dispositivo virtuale è composto da una simulazione JV in condizioni di oscurità e da nove simulazioni JV in condizioni di illuminazione. Di conseguenza, il numero totale di file di output può aumentare rapidamente.I risultati della simulazione vengono salvati in file ZIP, denominati archivi, e ogni archivio contiene \(N_{\mathrm{sim}}\) dispositivi virtuali. Nell’esempio mostrato, vengono generati e salvati 100 archivi, ciascuno dei quali contiene \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) dispositivi virtuali. È importante notare che, in questo esempio, ogni dispositivo virtuale è composto da una simulazione JV in condizioni di oscurità e da nove simulazioni JV in condizioni di illuminazione. Di conseguenza, il numero totale di file di output può aumentare rapidamente.
Per gestire questo processo, la generazione dei dati viene eseguita in blocchi. OghmaNano genera ed esegue un gruppo di \(N_{\mathrm{sim}}\) simulazioni, quindi le salva in un unico archivio, e questo processo viene ripetuto fino a quando non vengono prodotti \(N_{\mathrm{arc}}\) archivi. Questo approccio limita la perdita di dati all’archivio attualmente in fase di generazione in caso di interruzione del processo, e semplifica inoltre il trasferimento dei file e ne migliora la resistenza alla corruzione. L’esecuzione delle simulazioni è parallelizzata su tutti i core della CPU disponibili, mentre la creazione degli archivi viene eseguita su un singolo core.Per gestire questo processo, la generazione dei dati viene eseguita in blocchi. OghmaNano genera ed esegue un gruppo di \(N_{\mathrm{sim}}\) simulazioni, quindi le salva in un unico archivio, e questo processo viene ripetuto fino a quando non vengono prodotti \(N_{\mathrm{arc}}\) archivi. Questo approccio limita la perdita di dati all’archivio attualmente in fase di generazione in caso di interruzione del processo, e semplifica inoltre il trasferimento dei file e ne migliora la resistenza alla corruzione. L’esecuzione delle simulazioni è parallelizzata su tutti i core della CPU disponibili, mentre la creazione degli archivi viene eseguita su un singolo core.
6. Esecuzione del programma di generazione del set di dati.6. Esecuzione del programma di generazione del set di dati.
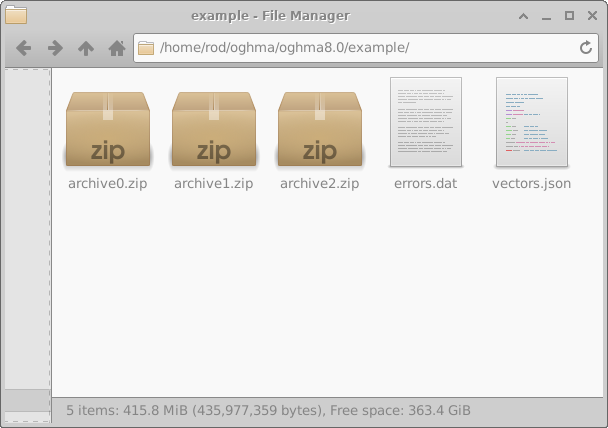
Una volta completata la configurazione, premendo il pulsante «Esegui generatore» nella finestra principale di Machine Learning (18.2) si avvia il processo di generazione del set di dati. A questo punto, OghmaNano inizierà a eseguire le simulazioni definite per ciascun dispositivo virtuale. Al termine del processo, nella directory di simulazione comparirà una directory denominata «example», come mostrato nella parte sinistra di 18.8. Ai fini di questo esempio, il parametro «Simulazioni per archivio» è stato impostato su 10 e il parametro «Numero di archivi» è stato impostato su 3, al fine di ridurre i tempi di esecuzione.Una volta completata la configurazione, premendo il pulsante «Esegui generatore» nella finestra principale di Machine Learning (18.2) si avvia il processo di generazione del set di dati. A questo punto, OghmaNano inizierà a eseguire le simulazioni definite per ciascun dispositivo virtuale. Al termine del processo, nella directory di simulazione comparirà una directory denominata «example», come mostrato nella parte sinistra di 18.8. Ai fini di questo esempio, il parametro «Simulazioni per archivio» è stato impostato su 10 e il parametro «Numero di archivi» è stato impostato su 3, al fine di ridurre i tempi di esecuzione.
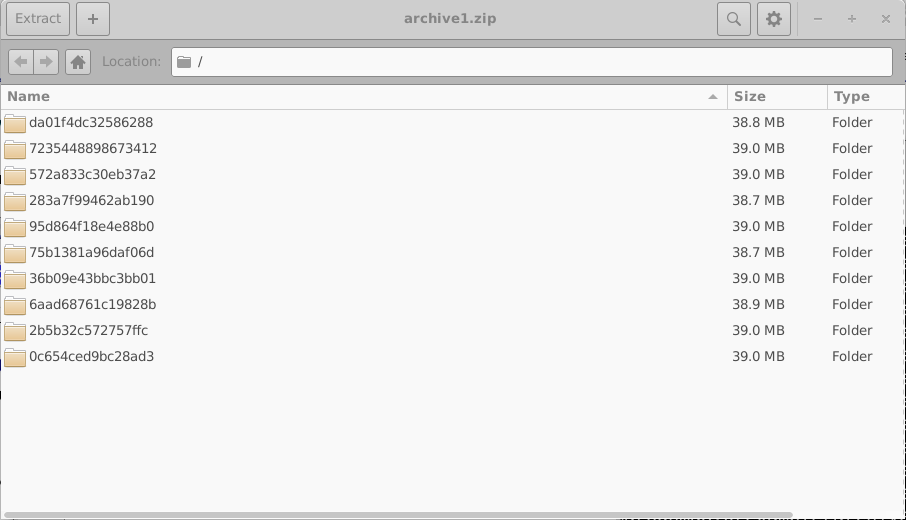
Eventuali errori riscontrati durante la simulazione vengono salvati nel file errors.dat. Aprendo archive0.zip, è possibile visualizzare la struttura interna di un archivio, come mostrato nella parte destra di 18.8. Ogni archivio contiene una raccolta di directory, ciascuna delle quali corrisponde a un singolo dispositivo virtuale.Eventuali errori riscontrati durante la simulazione vengono salvati nel file errors.dat. Aprendo archive0.zip, è possibile visualizzare la struttura interna di un archivio, come mostrato nella parte destra di 18.8. Ogni archivio contiene una raccolta di directory, ciascuna delle quali corrisponde a un singolo dispositivo virtuale.
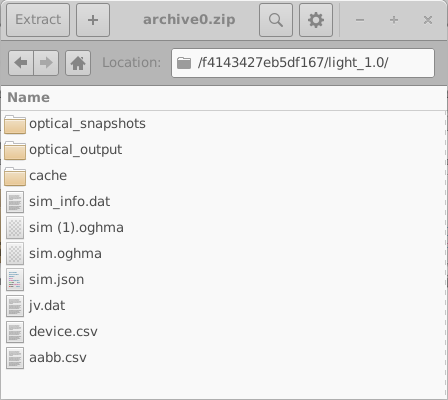
Queste directory sono denominate utilizzando identificatori esadecimali casuali di 16 cifre. Ogni directory contiene l’insieme completo delle simulazioni per un singolo dispositivo virtuale; in questo esempio, una simulazione JV in condizioni di oscurità e nove simulazioni JV in condizioni di illuminazione. Il contenuto di una di queste directory è mostrato nella parte sinistra di 18.10. Aprendo una singola directory di simulazione (18.10, a destra), si visualizza una simulazione OghmaNano completa, che include il file sim.json e il file jv.dat contenente le caratteristiche corrente-tensione simulate. Potrebbero essere presenti anche dati aggiuntivi, come i risultati ottici e i file di cache.Queste directory sono denominate utilizzando identificatori esadecimali casuali di 16 cifre. Ogni directory contiene l’insieme completo delle simulazioni per un singolo dispositivo virtuale; in questo esempio, una simulazione JV in condizioni di oscurità e nove simulazioni JV in condizioni di illuminazione. Il contenuto di una di queste directory è mostrato nella parte sinistra di 18.10. Aprendo una singola directory di simulazione (18.10, a destra), si visualizza una simulazione OghmaNano completa, che include il file sim.json e il file jv.dat contenente le caratteristiche corrente-tensione simulate. Potrebbero essere presenti anche dati aggiuntivi, come i risultati ottici e i file di cache.
Quando si generano grandi set di dati per l’apprendimento automatico, è fortemente consigliabile ridurre al minimo l’output non necessario, poiché lo spazio di archiviazione totale può aumentare rapidamente. Questo può essere ottenuto configurando la simulazione in modo che produca solo i dati di output essenziali. La generazione dei set di dati viene eseguita in batch, con simulazioni eseguite in parallelo su tutti i core della CPU disponibili, mentre la creazione degli archivi viene gestita su un singolo core.Quando si generano grandi set di dati per l’apprendimento automatico, è fortemente consigliabile ridurre al minimo l’output non necessario, poiché lo spazio di archiviazione totale può aumentare rapidamente. Questo può essere ottenuto configurando la simulazione in modo che produca solo i dati di output essenziali. La generazione dei set di dati viene eseguita in batch, con simulazioni eseguite in parallelo su tutti i core della CPU disponibili, mentre la creazione degli archivi viene gestita su un singolo core.
In questo esempio illustrativo, vengono generati solo tre archivi. In un ciclo di produzione tipico, tuttavia, è prassi generare circa 200 archivi, ciascuno dei quali contiene approssimativamente 200 dispositivi virtuali.In questo esempio illustrativo, vengono generati solo tre archivi. In un ciclo di produzione tipico, tuttavia, è prassi generare circa 200 archivi, ciascuno dei quali contiene approssimativamente 200 dispositivi virtuali.
In the above example we only have three archives but in a normal simulation run one would have up to 200 archives each with 200 simulations in each.
7. Riunire i risultati in un unico file.7. Riunire i risultati in un unico file.
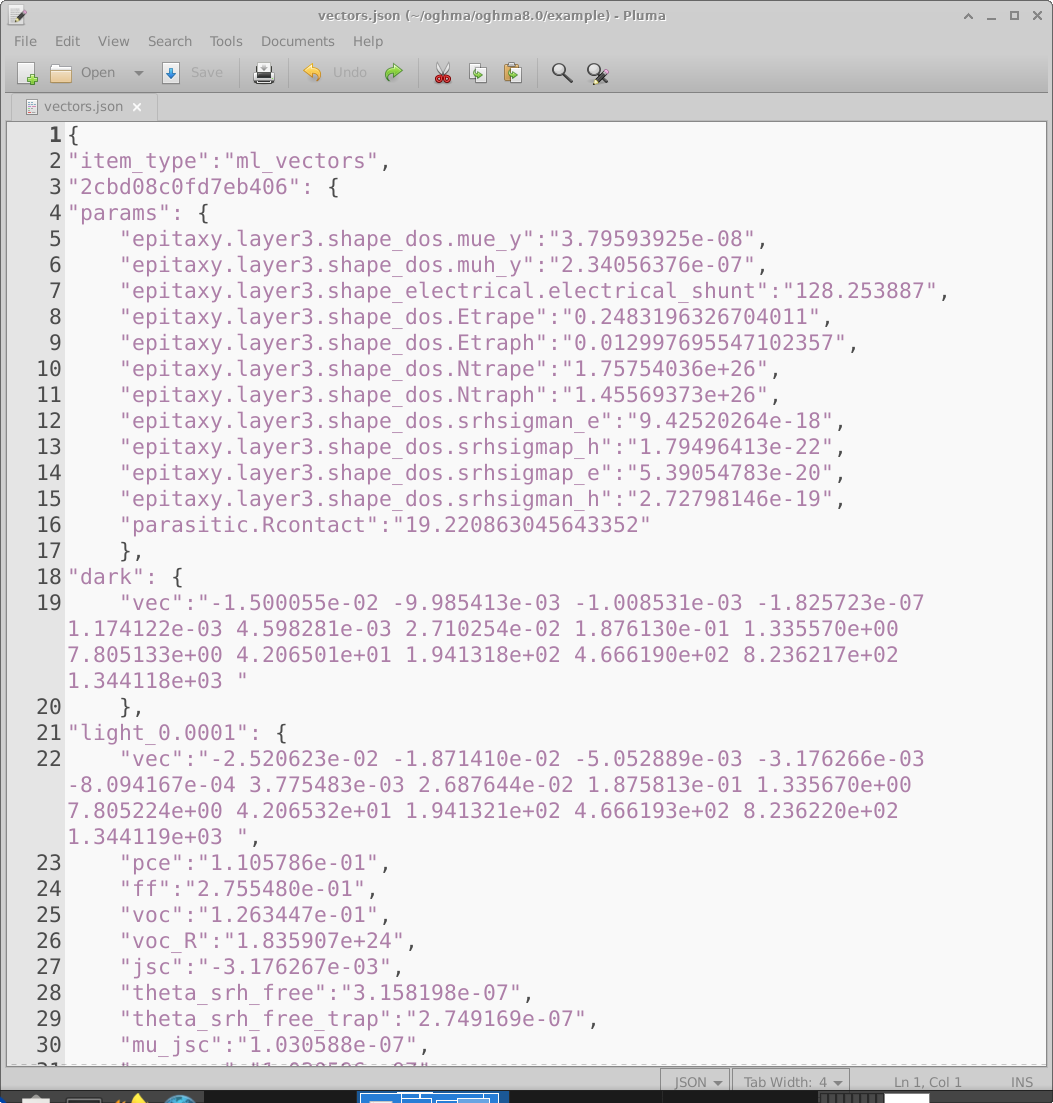
Una volta completate le simulazioni, i dati grezzi generati da OghmaNano devono essere convertiti in un unico file vettoriale, adatto per l’addestramento di un modello di apprendimento automatico. Cliccando sull’icona «Crea vettori» nella finestra principale dell’apprendimento automatico (18.2), OghmaNano apre ogni directory dei dispositivi virtuali, estrae i dati richiesti e li compila in un unico file vettoriale denominato vectors.json. Un esempio di questo file è mostrato in 18.11.Una volta completate le simulazioni, i dati grezzi generati da OghmaNano devono essere convertiti in un unico file vettoriale, adatto per l’addestramento di un modello di apprendimento automatico. Cliccando sull’icona «Crea vettori» nella finestra principale dell’apprendimento automatico (18.2), OghmaNano apre ogni directory dei dispositivi virtuali, estrae i dati richiesti e li compila in un unico file vettoriale denominato vectors.json. Un esempio di questo file è mostrato in 18.11.
Il file vettoriale è un documento JSON che contiene tutte le informazioni necessarie per l’apprendimento supervisionato. Ogni dispositivo virtuale è rappresentato come una voce distinta. Ad esempio, la voce contrassegnata come 2cbd08c0fd7eb406 (riga 3) contiene, nella sezione «params», i parametri elettrici selezionati in modo casuale per quel dispositivo virtuale. A questa seguono i vettori di input estratti, come il vettore JV al buio (riga 19) e il vettore JV in condizioni di illuminazione a 0,0001 Suns (riga 22). Le unità di misura di ciascun vettore vengono ereditate direttamente dal file di origine da cui sono stati estratti. In questo esempio, i vettori sono tratti da jv.dat, che memorizza la densità di corrente in \(A\,m^{-2}\) in funzione della tensione, quindi i valori dei vettori sono espressi in \(A\,m^{-2}\). Dopo i vettori di input, vengono memorizzati, per comodità, ulteriori valori scalari in output (ad esempio, PCE).Il file vettoriale è un documento JSON che contiene tutte le informazioni necessarie per l’apprendimento supervisionato. Ogni dispositivo virtuale è rappresentato come una voce distinta. Ad esempio, la voce contrassegnata come 2cbd08c0fd7eb406 (riga 3) contiene, nella sezione «params», i parametri elettrici selezionati in modo casuale per quel dispositivo virtuale. A questa seguono i vettori di input estratti, come il vettore JV al buio (riga 19) e il vettore JV in condizioni di illuminazione a 0,0001 Suns (riga 22). Le unità di misura di ciascun vettore vengono ereditate direttamente dal file di origine da cui sono stati estratti. In questo esempio, i vettori sono tratti da jv.dat, che memorizza la densità di corrente in \(A\,m^{-2}\) in funzione della tensione, quindi i valori dei vettori sono espressi in \(A\,m^{-2}\). Dopo i vettori di input, vengono memorizzati, per comodità, ulteriori valori scalari in output (ad esempio, PCE).
In questo file sarà presente una voce per ogni dispositivo virtuale generato. Una volta creato il file vectors.json, questo potrà essere utilizzato come set di dati di addestramento per il flusso di lavoro di machine learning desiderato. Alcuni utenti ritengono più semplice importare i dati in TensorFlow dopo averli convertiti in formato CSV; questa operazione può essere eseguita utilizzando le librerie Python standard.In questo file sarà presente una voce per ogni dispositivo virtuale generato. Una volta creato il file vectors.json, questo potrà essere utilizzato come set di dati di addestramento per il flusso di lavoro di machine learning desiderato. Alcuni utenti ritengono più semplice importare i dati in TensorFlow dopo averli convertiti in formato CSV; questa operazione può essere eseguita utilizzando le librerie Python standard.
8. From data set to machine learning
Le sezioni precedenti descrivono come OghmaNano viene utilizzato per generare un set di dati completo per l’apprendimento automatico in formato JSON. A questo punto, il processo di generazione dei dati è completo: per ciascun dispositivo virtuale, il file contiene i parametri del modello selezionati in modo casuale, insieme ai corrispondenti risultati della simulazione, codificati come vettori di input.Le sezioni precedenti descrivono come OghmaNano viene utilizzato per generare un set di dati completo per l’apprendimento automatico in formato JSON. A questo punto, il processo di generazione dei dati è completo: per ciascun dispositivo virtuale, il file contiene i parametri del modello selezionati in modo casuale, insieme ai corrispondenti risultati della simulazione, codificati come vettori di input.
Il passaggio successivo consiste nell’importare questi dati in un ambiente di apprendimento automatico a scelta. In pratica, ciò implica in genere la lettura del file vectors.json e la sua conversione in un formato tabellare, come CSV, che può quindi essere utilizzato per l’addestramento, la convalida e il test. Questa conversione può essere eseguita in modo semplice utilizzando strumenti di scripting standard (ad esempio, Python).Il passaggio successivo consiste nell’importare questi dati in un ambiente di apprendimento automatico a scelta. In pratica, ciò implica in genere la lettura del file vectors.json e la sua conversione in un formato tabellare, come CSV, che può quindi essere utilizzato per l’addestramento, la convalida e il test. Questa conversione può essere eseguita in modo semplice utilizzando strumenti di scripting standard (ad esempio, Python).
Una volta convertiti, i dati possono essere utilizzati per addestrare una rete neurale o un altro modello di regressione implementato tramite un framework di apprendimento automatico come TensorFlow, PyTorch o una libreria simile. A partire da questo momento, la scelta dell’architettura della rete, della funzione di perdita e della strategia di addestramento dipende dall’applicazione specifica e non è vincolata a OghmaNano.Una volta convertiti, i dati possono essere utilizzati per addestrare una rete neurale o un altro modello di regressione implementato tramite un framework di apprendimento automatico come TensorFlow, PyTorch o una libreria simile. A partire da questo momento, la scelta dell’architettura della rete, della funzione di perdita e della strategia di addestramento dipende dall’applicazione specifica e non è vincolata a OghmaNano.
In questo modo, OghmaNano offre un flusso di lavoro completo e automatizzato per la generazione di dati di addestramento coerenti dal punto di vista fisico, lasciando che lo sviluppo e l’ottimizzazione successivi del modello di machine learning siano interamente sotto il controllo dell’utente.In questo modo, OghmaNano offre un flusso di lavoro completo e automatizzato per la generazione di dati di addestramento coerenti dal punto di vista fisico, lasciando che lo sviluppo e l’ottimizzazione successivi del modello di machine learning siano interamente sotto il controllo dell’utente.