

Makine Öğrenimi için Veri Kümeleri OluşturmaMakine Öğrenimi için Veri Kümeleri Oluşturma
Bu bölüm, OghmaNano kullanılarak makine öğrenimi veri kümelerinin nasıl oluşturulacağını açıklamaktadır. Genellikle bu veri kümeleri dışarı aktarılır ve eğitim, çıkarım veya tahmin için TensorFlow gibi harici çerçeveler kullanılarak işlenir.Bu bölüm, OghmaNano kullanılarak makine öğrenimi veri kümelerinin nasıl oluşturulacağını açıklamaktadır. Genellikle bu veri kümeleri dışarı aktarılır ve eğitim, çıkarım veya tahmin için TensorFlow gibi harici çerçeveler kullanılarak işlenir.
1. Giriş1. Giriş
Genellikle, deneysel verilerden fiziksel cihaz parametrelerini elde etmek için modelleme kullanmak faydalıdır. Örneğin, bir dizi JV eğrisi olabilir ve cihazın yük taşıyıcı hareketliliğini ve rekombinasyon oranını belirlemek istenebilir. Geleneksel olarak, bu, OghmaNano gibi fizik temelli bir modelin verilere uyarlanmasıyla gerçekleştirilir (bkz. uyarlama öğreticisi). Bu yaklaşımın dezavantajı, tek bir veri kümesine uyarlama yapmanın zaman alıcı olabilmesi ve birden fazla veri kümesinin analiz edilmesi gerektiğinde zorluğun önemli ölçüde artmasıdır. Uyarlama süreci karmaşıktır ve genellikle sayısal simülasyon konusunda önemli uzmanlık ve önemli ölçüde manuel müdahale gerektirir. Sonuç olarak, ayrıntılı cihaz uyarlaması yalnızca topluluğun nispeten küçük bir bölümü tarafından gerçekleştirilir.Genellikle, deneysel verilerden fiziksel cihaz parametrelerini elde etmek için modelleme kullanmak faydalıdır. Örneğin, bir dizi JV eğrisi olabilir ve cihazın yük taşıyıcı hareketliliğini ve rekombinasyon oranını belirlemek istenebilir. Geleneksel olarak, bu, OghmaNano gibi fizik temelli bir modelin verilere uyarlanmasıyla gerçekleştirilir (bkz. uyarlama öğreticisi). Bu yaklaşımın dezavantajı, tek bir veri kümesine uyarlama yapmanın zaman alıcı olabilmesi ve birden fazla veri kümesinin analiz edilmesi gerektiğinde zorluğun önemli ölçüde artmasıdır. Uyarlama süreci karmaşıktır ve genellikle sayısal simülasyon konusunda önemli uzmanlık ve önemli ölçüde manuel müdahale gerektirir. Sonuç olarak, ayrıntılı cihaz uyarlaması yalnızca topluluğun nispeten küçük bir bölümü tarafından gerçekleştirilir.
Daha modern bir yaklaşım, makine öğrenimi kullanmaktır. Tek bir JV eğrisini doğrudan uygulamak yerine, öncelikle cihazın yapısını temsil eden bir simülasyon oluşturulur. Bireysel elektriksel parametreleri optimize etmek yerine, bu cihazın rastgele seçilmiş parametre değerlerine sahip binlerce kopyası oluşturulur. Bu örneklerin her biri, sanal cihaz olarak adlandırılır. Ardından, OghmaNano gibi bir simülasyon programı kullanılarak her sanal cihaz için JV eğrileri oluşturulur ve bu, ilgili elektriksel parametrelerle eşleştirilmiş JV eğrilerinden oluşan bir veri kümesi elde edilir. Bu veri, bir makine öğrenimi modelini, JV özelliklerinden doğrudan elektriksel parametreleri tahmin etmek üzere eğitmek için kullanılabilir. Bu çerçevede, OghmaNano, elektriksel parametreleri simüle edilmiş deneysel verilere eşleyen bir ileri dönüşüm görevi görürken, makine öğrenimi modeli ters dönüşümü sağlar. Eğitim tamamlandıktan sonra, model gerçek cihazlardan malzeme parametrelerini çıkarmak için kullanılabilir.Daha modern bir yaklaşım, makine öğrenimi kullanmaktır. Tek bir JV eğrisini doğrudan uygulamak yerine, öncelikle cihazın yapısını temsil eden bir simülasyon oluşturulur. Bireysel elektriksel parametreleri optimize etmek yerine, bu cihazın rastgele seçilmiş parametre değerlerine sahip binlerce kopyası oluşturulur. Bu örneklerin her biri, sanal cihaz olarak adlandırılır. Ardından, OghmaNano gibi bir simülasyon programı kullanılarak her sanal cihaz için JV eğrileri oluşturulur ve bu, ilgili elektriksel parametrelerle eşleştirilmiş JV eğrilerinden oluşan bir veri kümesi elde edilir. Bu veri, bir makine öğrenimi modelini, JV özelliklerinden doğrudan elektriksel parametreleri tahmin etmek üzere eğitmek için kullanılabilir. Bu çerçevede, OghmaNano, elektriksel parametreleri simüle edilmiş deneysel verilere eşleyen bir ileri dönüşüm görevi görürken, makine öğrenimi modeli ters dönüşümü sağlar. Eğitim tamamlandıktan sonra, model gerçek cihazlardan malzeme parametrelerini çıkarmak için kullanılabilir.
Bu yaklaşımın temel avantajı, bir kez eğitildikten sonra makine öğrenimi modelinin, kullanıcıdan sayısal simülasyon konusunda uzman olmasını gerektirmeden, deneysel verilerden birkaç saniye içinde malzeme parametrelerini çıkarabilmesidir. Ancak, bu yöntemin başarısı, büyük ve yüksek kaliteli bir eğitim veri kümesinin oluşturulmasına büyük ölçüde bağlıdır. OghmaNano kullanılarak bu tür veri kümelerinin oluşturulma süreci, aşağıdaki sayfalarda açıklanmıştır.Bu yaklaşımın temel avantajı, bir kez eğitildikten sonra makine öğrenimi modelinin, kullanıcıdan sayısal simülasyon konusunda uzman olmasını gerektirmeden, deneysel verilerden birkaç saniye içinde malzeme parametrelerini çıkarabilmesidir. Ancak, bu yöntemin başarısı, büyük ve yüksek kaliteli bir eğitim veri kümesinin oluşturulmasına büyük ölçüde bağlıdır. OghmaNano kullanılarak bu tür veri kümelerinin oluşturulma süreci, aşağıdaki sayfalarda açıklanmıştır.
2. Örneği açma2. Örneği açma
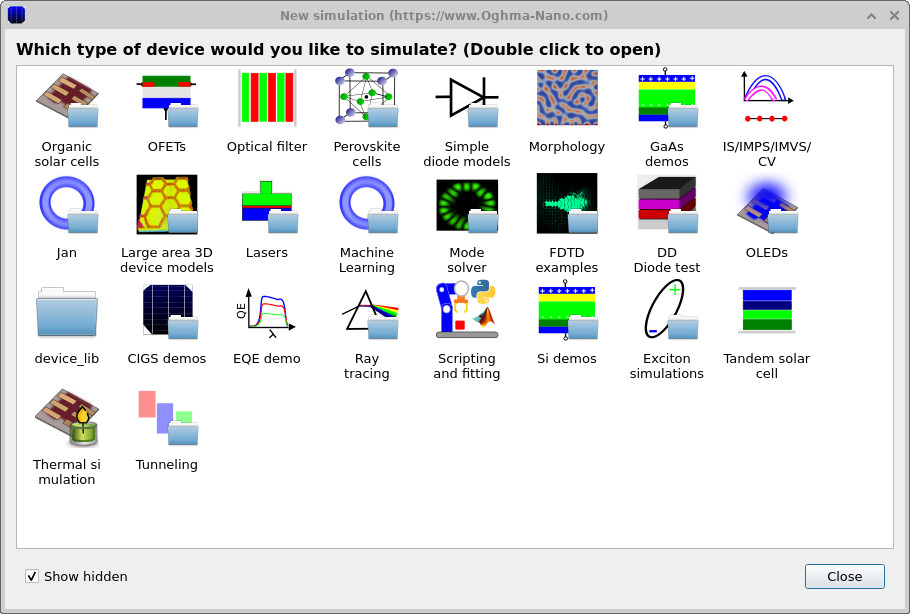
Bu sayfada açıklanan örnek, ana penceredeki "Yeni Simülasyon" düğmesi aracılığıyla erişilebilir. Bu, ??'de gösterilen "Yeni Simülasyon" tarayıcısını açar.Bu sayfada açıklanan örnek, ana penceredeki "Yeni Simülasyon" düğmesi aracılığıyla erişilebilir. Bu, ??'de gösterilen "Yeni Simülasyon" tarayıcısını açar.
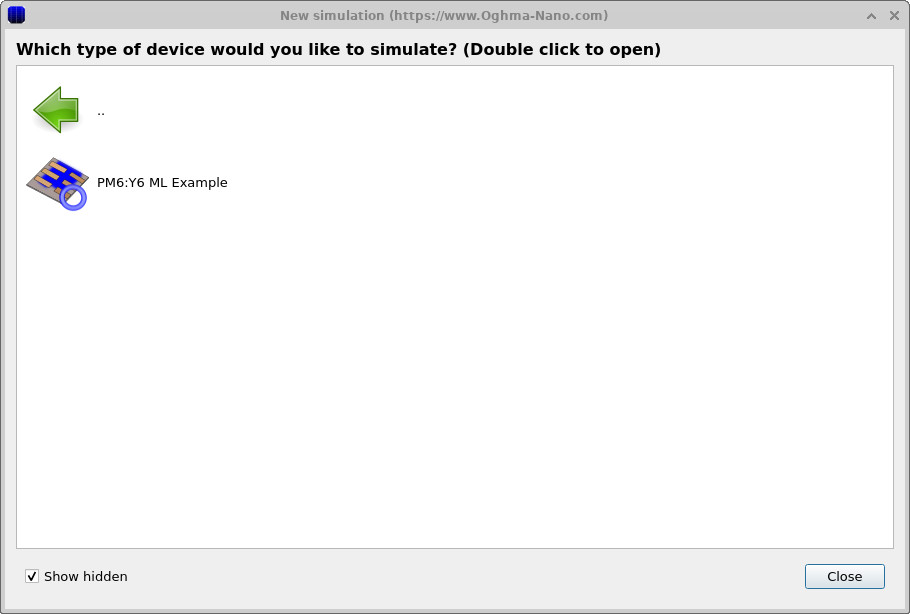
Mevcut simülasyon kategorileri listesinden, makine öğrenimi örneklerini görüntülemek için Makine Öğrenimi seçeneğine çift tıklayın (??). PM6:Y6 ML örneğini seçmek, bu bölümde açıklanan cihaza ve iş akışına karşılık gelen, önceden yapılandırılmış bir simülasyonu yükler.Mevcut simülasyon kategorileri listesinden, makine öğrenimi örneklerini görüntülemek için Makine Öğrenimi seçeneğine çift tıklayın (??). PM6:Y6 ML örneğini seçmek, bu bölümde açıklanan cihaza ve iş akışına karşılık gelen, önceden yapılandırılmış bir simülasyonu yükler.
Simülasyon açıldıktan sonra, bu bölüm boyunca kullanılan aynı cihaz yapısı ve otomasyon ayarları görüntülenir ve ek bir yapılandırmaya gerek kalmadan doğrudan makine öğrenimi eğitim verisi oluşturmak için kullanılabilir.Simülasyon açıldıktan sonra, bu bölüm boyunca kullanılan aynı cihaz yapısı ve otomasyon ayarları görüntülenir ve ek bir yapılandırmaya gerek kalmadan doğrudan makine öğrenimi eğitim verisi oluşturmak için kullanılabilir.
3. Simülasyonların ve çıktı vektörlerinin tanımlanması3. Simülasyonların ve çıktı vektörlerinin tanımlanması
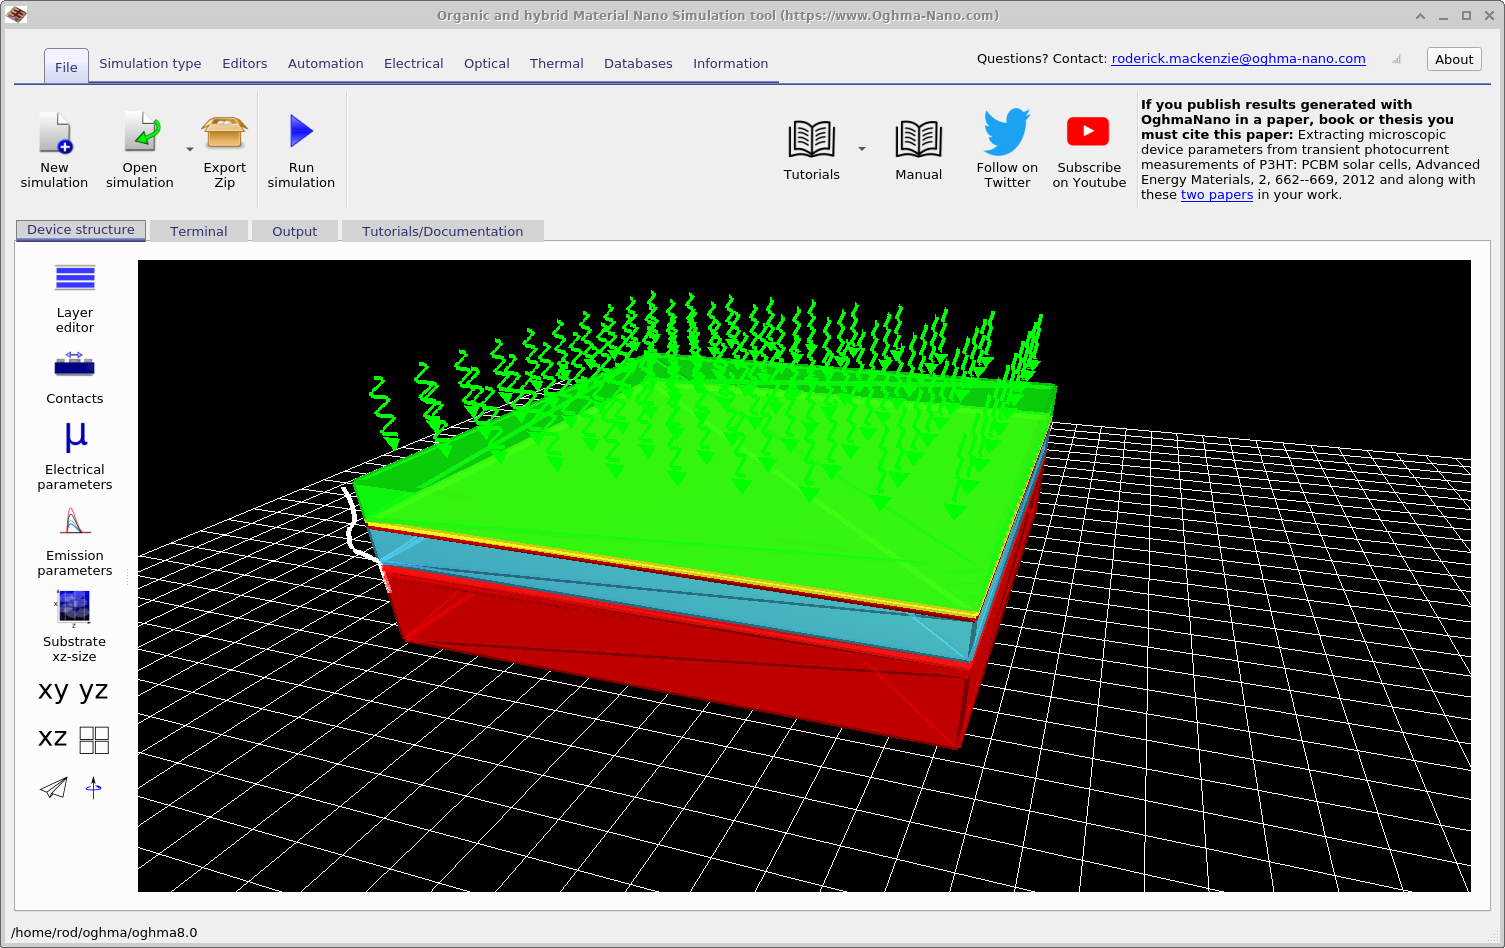
Örnek simülasyon açıldıktan sonra, Şekil ??'de gösterilen ana simülasyon penceresi görüntülenecektir. Bu pencere, bu bölüm boyunca kullanılan, tamamen yapılandırılmış cihaz yapısını gösterir. Otomasyon şeridinde, mavi bir daire simgesiyle temsil edilen bir Makine Öğrenimi simgesi görünür. Bu simgeye tıklamak, Şekil ??'de gösterilen ana makine öğrenimi kontrol penceresini açar. Bu pencereden, makine öğrenimi eğitim verilerinin oluşturulması yapılandırılır ve yürütülür.Örnek simülasyon açıldıktan sonra, Şekil ??'de gösterilen ana simülasyon penceresi görüntülenecektir. Bu pencere, bu bölüm boyunca kullanılan, tamamen yapılandırılmış cihaz yapısını gösterir. Otomasyon şeridinde, mavi bir daire simgesiyle temsil edilen bir Makine Öğrenimi simgesi görünür. Bu simgeye tıklamak, Şekil ??'de gösterilen ana makine öğrenimi kontrol penceresini açar. Bu pencereden, makine öğrenimi eğitim verilerinin oluşturulması yapılandırılır ve yürütülür.
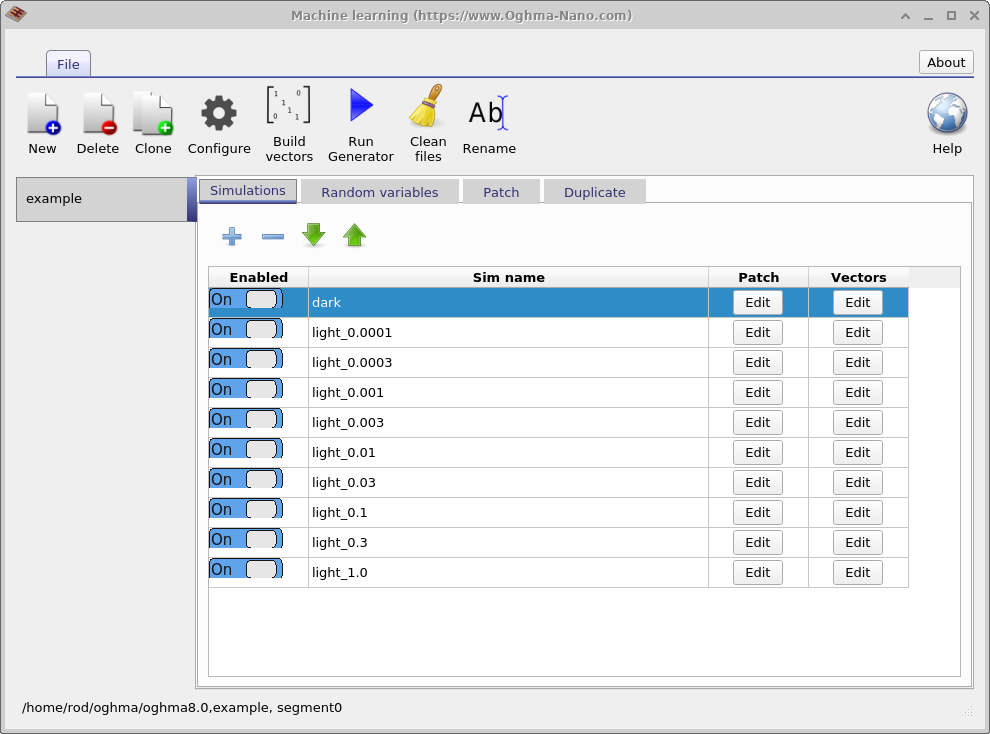
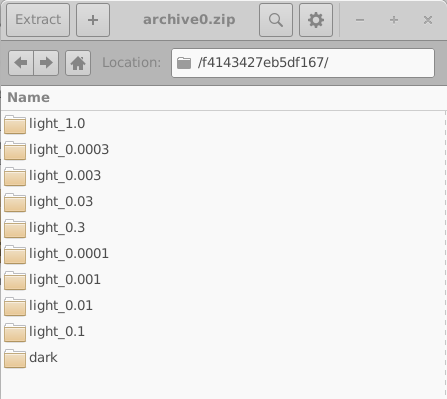
Bu pencerenin temel amacı, makine öğrenimi algoritmalarını eğitmek için büyük veri kümeleri oluşturmaktır. Bu örnekte oluşturulan veri kümesine "örnek" adı verilmiştir. Görünen ilk sekme, her bir sanal cihaz için gerçekleştirilen simülasyon kümesini tanımlayan "Simülasyonlar" sekmesidir. Bu durumda, karanlık bir JV eğrisi ve 0,0001 Güneş'ten 1,0 Güneş'e kadar değişen ışık yoğunluklarına sahip dokuz aydınlatılmış JV eğrisi simüle edilmiştir. Bireysel simülasyonlar, "Etkin" düğmesi kullanılarak etkinleştirilebilir veya devre dışı bırakılabilir. "\(light\_0.0001\)" girdisi için "Yama" sütunundaki "Düzenle" düğmesine tıklanırsa, ??'de gösterilen "Yama" penceresi açılır.Bu pencerenin temel amacı, makine öğrenimi algoritmalarını eğitmek için büyük veri kümeleri oluşturmaktır. Bu örnekte oluşturulan veri kümesine "örnek" adı verilmiştir. Görünen ilk sekme, her bir sanal cihaz için gerçekleştirilen simülasyon kümesini tanımlayan "Simülasyonlar" sekmesidir. Bu durumda, karanlık bir JV eğrisi ve 0,0001 Güneş'ten 1,0 Güneş'e kadar değişen ışık yoğunluklarına sahip dokuz aydınlatılmış JV eğrisi simüle edilmiştir. Bireysel simülasyonlar, "Etkin" düğmesi kullanılarak etkinleştirilebilir veya devre dışı bırakılabilir. "\(light\_0.0001\)" girdisi için "Yama" sütunundaki "Düzenle" düğmesine tıklanırsa, ??'de gösterilen "Yama" penceresi açılır.
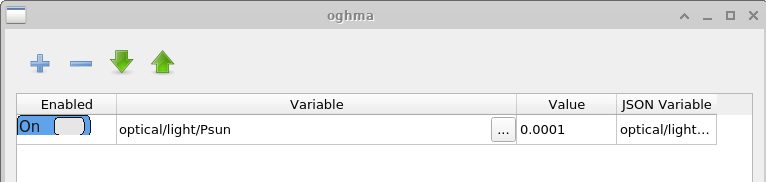
Yama penceresinin amacı, sanal bir simülasyon içindeki parametreleri değiştirmektir. Bu örnekte, aynı temel cihaz yapısı kullanılarak farklı aydınlatma koşulları altında birden fazla JV eğrisi oluşturulmaktadır. Bunu gerçekleştirmek için, her bir simülasyon için ışık yoğunluğu bağımsız olarak ayarlanmalıdır. \(light\_0.0001\) için yama penceresini açtığımızda, aydınlatma yoğunluğunu kontrol eden simülasyon parametresi olan optical/light/Psun'ın \(0.0001\) olarak ayarlandığı görülür. Karanlık simülasyon için aynı parametre \(0.0\) olarak ayarlanır. Bu şekilde, tek bir temel simülasyon kullanılarak birden fazla deneysel koşul tutarlı bir şekilde simüle edilebilir.Yama penceresinin amacı, sanal bir simülasyon içindeki parametreleri değiştirmektir. Bu örnekte, aynı temel cihaz yapısı kullanılarak farklı aydınlatma koşulları altında birden fazla JV eğrisi oluşturulmaktadır. Bunu gerçekleştirmek için, her bir simülasyon için ışık yoğunluğu bağımsız olarak ayarlanmalıdır. \(light\_0.0001\) için yama penceresini açtığımızda, aydınlatma yoğunluğunu kontrol eden simülasyon parametresi olan optical/light/Psun'ın \(0.0001\) olarak ayarlandığı görülür. Karanlık simülasyon için aynı parametre \(0.0\) olarak ayarlanır. Bu şekilde, tek bir temel simülasyon kullanılarak birden fazla deneysel koşul tutarlı bir şekilde simüle edilebilir.
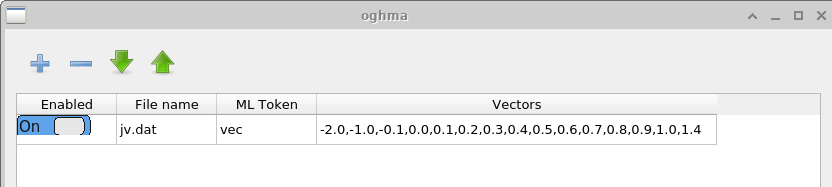
Vektörler penceresi, tamamlanmış simülasyonlardan hangi verilerin alınarak makine öğrenimi için kullanılacak girdi vektörlerinin oluşturulacağını tanımlar. Bu örnekte, simüle edilmiş akım-gerilim özelliklerini içeren \(jv.dat\) dosyasından -2,0 V ile 1,4 V arasındaki veri noktaları alınır. Zaman alanlı simülasyonlar için, kullanıcı bunun yerine \(time\_i.csv\) veya diğer uygun bir çıktı dosyasından veri alabilir. Her bir girdi vektörünü oluşturmak için kullanılan nokta sayısı kullanıcı tarafından belirlenir. Daha uzun vektörler, eğitim sürecinin hesaplama maliyetini artırır, ancak akım-gerilim eğrisinin daha ayrıntılı özelliklerini yakalayabilir.Vektörler penceresi, tamamlanmış simülasyonlardan hangi verilerin alınarak makine öğrenimi için kullanılacak girdi vektörlerinin oluşturulacağını tanımlar. Bu örnekte, simüle edilmiş akım-gerilim özelliklerini içeren \(jv.dat\) dosyasından -2,0 V ile 1,4 V arasındaki veri noktaları alınır. Zaman alanlı simülasyonlar için, kullanıcı bunun yerine \(time\_i.csv\) veya diğer uygun bir çıktı dosyasından veri alabilir. Her bir girdi vektörünü oluşturmak için kullanılan nokta sayısı kullanıcı tarafından belirlenir. Daha uzun vektörler, eğitim sürecinin hesaplama maliyetini artırır, ancak akım-gerilim eğrisinin daha ayrıntılı özelliklerini yakalayabilir.
4. Rastgele değişkenlerin tanımlanması4. Rastgele değişkenlerin tanımlanması
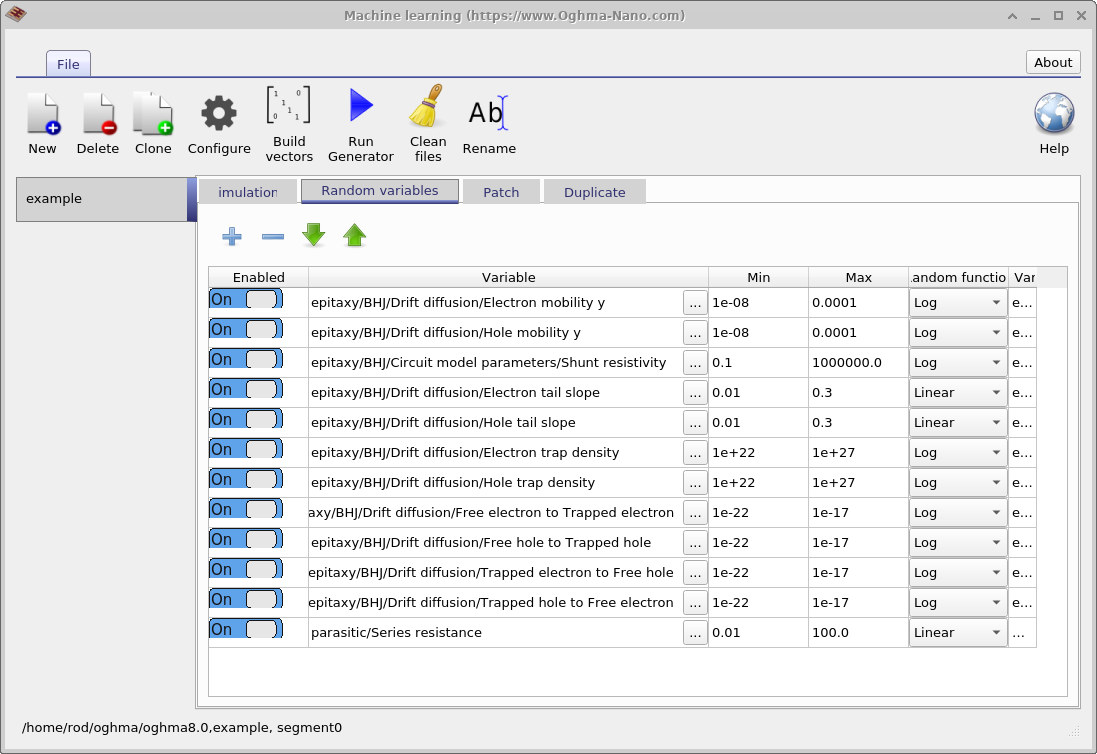
Bir sonraki adım, hangi model parametrelerinin rastgeleleştirileceğinin belirlenmesidir. Bu işlem, ana makine öğrenimi penceresindeki Rastgele Değişkenler sekmesi kullanılarak yapılır. Tablo beş sütundan oluşur. Etkin sütunu, bir parametrenin rastgeleleştirme işlemine dahil edilip edilmeyeceğini belirler. Değişken sütunu, hangi simülasyon parametresinin değiştirileceğini belirtir. Minimum ve Maksimum sütunları, parametre aralığının alt ve üst sınırlarını tanımlar ve Rastgele fonksiyon sütunu, değerlerin doğrusal veya logaritmik bir dağılımdan mı çekileceğini belirtir.Bir sonraki adım, hangi model parametrelerinin rastgeleleştirileceğinin belirlenmesidir. Bu işlem, ana makine öğrenimi penceresindeki Rastgele Değişkenler sekmesi kullanılarak yapılır. Tablo beş sütundan oluşur. Etkin sütunu, bir parametrenin rastgeleleştirme işlemine dahil edilip edilmeyeceğini belirler. Değişken sütunu, hangi simülasyon parametresinin değiştirileceğini belirtir. Minimum ve Maksimum sütunları, parametre aralığının alt ve üst sınırlarını tanımlar ve Rastgele fonksiyon sütunu, değerlerin doğrusal veya logaritmik bir dağılımdan mı çekileceğini belirtir.
Birden fazla büyüklük derecesini kapsayan parametreler için logaritmik dağılımlar önerilirken, nispeten dar bir aralıkta değişen parametreler için doğrusal dağılımlar daha uygundur. Logaritmik bir dağıtım kullanmak, değerlerin logaritmik ölçekte incelendiğinde eşit aralıklarla örneklenmesini ve aralığın üst ucuna doğru yığılmasını önler. Örneğin, uygun bir doğrusal parametre, tipik olarak 30 ile 150 meV arasında değişen Urbach enerjisi olabilir. Buna karşılık, tuzak yoğunlukları logaritmik örnekleme için daha uygundur, çünkü \(1 \times 10^{15}\,\mathrm{m^{-3}}\) ile \(1 \times 10^{25}\,\mathrm{m^{-3}}\) arasında değişebilirler.Birden fazla büyüklük derecesini kapsayan parametreler için logaritmik dağılımlar önerilirken, nispeten dar bir aralıkta değişen parametreler için doğrusal dağılımlar daha uygundur. Logaritmik bir dağıtım kullanmak, değerlerin logaritmik ölçekte incelendiğinde eşit aralıklarla örneklenmesini ve aralığın üst ucuna doğru yığılmasını önler. Örneğin, uygun bir doğrusal parametre, tipik olarak 30 ile 150 meV arasında değişen Urbach enerjisi olabilir. Buna karşılık, tuzak yoğunlukları logaritmik örnekleme için daha uygundur, çünkü \(1 \times 10^{15}\,\mathrm{m^{-3}}\) ile \(1 \times 10^{25}\,\mathrm{m^{-3}}\) arasında değişebilirler.
5. Simülasyon sayısının belirlenmesi5. Simülasyon sayısının belirlenmesi
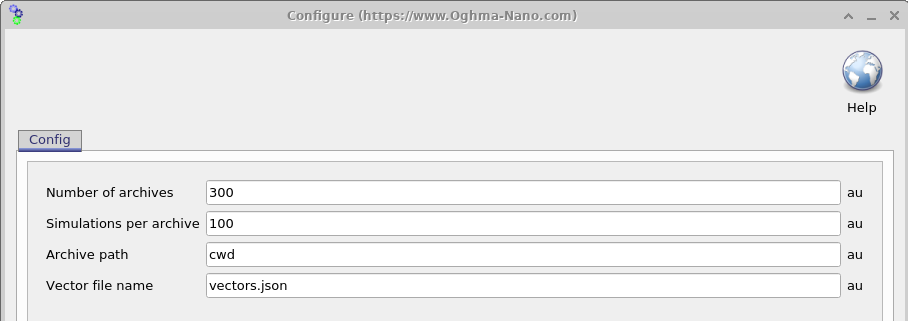
Simülasyon yapılandırıldıktan sonra, bir sonraki adım, rastgele parametrelere sahip kaç adet sanal cihazın oluşturulacağını belirlemektir. Ayarlar penceresini açmak (18.6 bölümüne bakın), bu işlemin iki parametre kullanılarak kontrol edilmesini sağlar: Arşiv başına simülasyon sayısı (\(N_{\mathrm{sim}}\)) ve Arşiv sayısı (\(N_{\mathrm{arc}}\)). Oluşturulan toplam sanal cihaz sayısı \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\) ile belirtilir.Simülasyon yapılandırıldıktan sonra, bir sonraki adım, rastgele parametrelere sahip kaç adet sanal cihazın oluşturulacağını belirlemektir. Ayarlar penceresini açmak (18.6 bölümüne bakın), bu işlemin iki parametre kullanılarak kontrol edilmesini sağlar: Arşiv başına simülasyon sayısı (\(N_{\mathrm{sim}}\)) ve Arşiv sayısı (\(N_{\mathrm{arc}}\)). Oluşturulan toplam sanal cihaz sayısı \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\) ile belirtilir.
Simülasyon sonuçları, her birinde \(N_{\mathrm{sim}}\) adet sanal cihaz bulunan ve arşiv olarak adlandırılan ZIP dosyalarına kaydedilir. Burada gösterilen örnekte, \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) adet sanal cihaz oluşturulur ve 100 adet arşiv dosyasına dağıtılarak saklanır. Bu örnekte, her sanal cihazın bir adet karanlık JV simülasyonu ve dokuz adet aydınlatılmış JV simülasyonundan oluştuğuna dikkat etmek önemlidir. Sonuç olarak, oluşturulan çıktı dosyalarının toplam sayısı hızla artabilir.Simülasyon sonuçları, her birinde \(N_{\mathrm{sim}}\) adet sanal cihaz bulunan ve arşiv olarak adlandırılan ZIP dosyalarına kaydedilir. Burada gösterilen örnekte, \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) adet sanal cihaz oluşturulur ve 100 adet arşiv dosyasına dağıtılarak saklanır. Bu örnekte, her sanal cihazın bir adet karanlık JV simülasyonu ve dokuz adet aydınlatılmış JV simülasyonundan oluştuğuna dikkat etmek önemlidir. Sonuç olarak, oluşturulan çıktı dosyalarının toplam sayısı hızla artabilir.
Bunu yönetmek için veri üretimi, gruplar halinde gerçekleştirilir. Bir grup \(N_{\mathrm{sim}}\) simülasyonu oluşturulur ve OghmaNano tarafından çalıştırılır, ardından tek bir arşive kaydedilir ve bu işlem \(N_{\mathrm{arc}}\) arşiv oluşturulana kadar tekrarlanır. Bu yaklaşım, işlem kesintiye uğradığında veri kaybını, şu anda oluşturulan arşivle sınırlar ve aynı zamanda dosya aktarımını kolaylaştırır ve bozulmaya karşı direnci artırır. Simülasyon yürütme işlemi, mevcut tüm CPU çekirdekleri üzerinde paralel olarak gerçekleştirilirken, arşiv oluşturma işlemi tek bir çekirdek üzerinde yapılır.Bunu yönetmek için veri üretimi, gruplar halinde gerçekleştirilir. Bir grup \(N_{\mathrm{sim}}\) simülasyonu oluşturulur ve OghmaNano tarafından çalıştırılır, ardından tek bir arşive kaydedilir ve bu işlem \(N_{\mathrm{arc}}\) arşiv oluşturulana kadar tekrarlanır. Bu yaklaşım, işlem kesintiye uğradığında veri kaybını, şu anda oluşturulan arşivle sınırlar ve aynı zamanda dosya aktarımını kolaylaştırır ve bozulmaya karşı direnci artırır. Simülasyon yürütme işlemi, mevcut tüm CPU çekirdekleri üzerinde paralel olarak gerçekleştirilirken, arşiv oluşturma işlemi tek bir çekirdek üzerinde yapılır.
6. Veri kümesi oluşturma aracını çalıştırma6. Veri kümesi oluşturma aracını çalıştırma
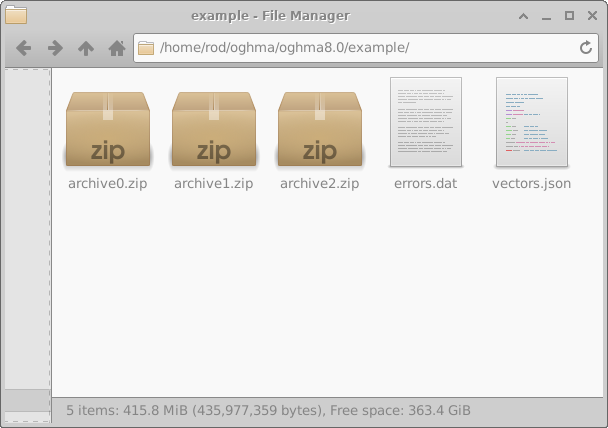
Yapılandırma tamamlandıktan sonra, ana Makine Öğrenimi penceresindeki "Oluşturucu'yu Çalıştır" düğmesine basmak, veri kümesi oluşturma işlemini başlatır (18.2). Ardından OghmaNano, her sanal cihaz için tanımlanan simülasyonları çalıştırmaya başlar. İşlem tamamlandığında, simülasyon dizininde "example" adlı bir dizin oluşur; bu, 18.8'in sol tarafında gösterildiği gibidir. Bu örnek için, çalışma süresini kısaltmak amacıyla "Arşiv başına simülasyon sayısı" 10'a ve "Arşiv sayısı" 3'e ayarlanmıştır.Yapılandırma tamamlandıktan sonra, ana Makine Öğrenimi penceresindeki "Oluşturucu'yu Çalıştır" düğmesine basmak, veri kümesi oluşturma işlemini başlatır (18.2). Ardından OghmaNano, her sanal cihaz için tanımlanan simülasyonları çalıştırmaya başlar. İşlem tamamlandığında, simülasyon dizininde "example" adlı bir dizin oluşur; bu, 18.8'in sol tarafında gösterildiği gibidir. Bu örnek için, çalışma süresini kısaltmak amacıyla "Arşiv başına simülasyon sayısı" 10'a ve "Arşiv sayısı" 3'e ayarlanmıştır.
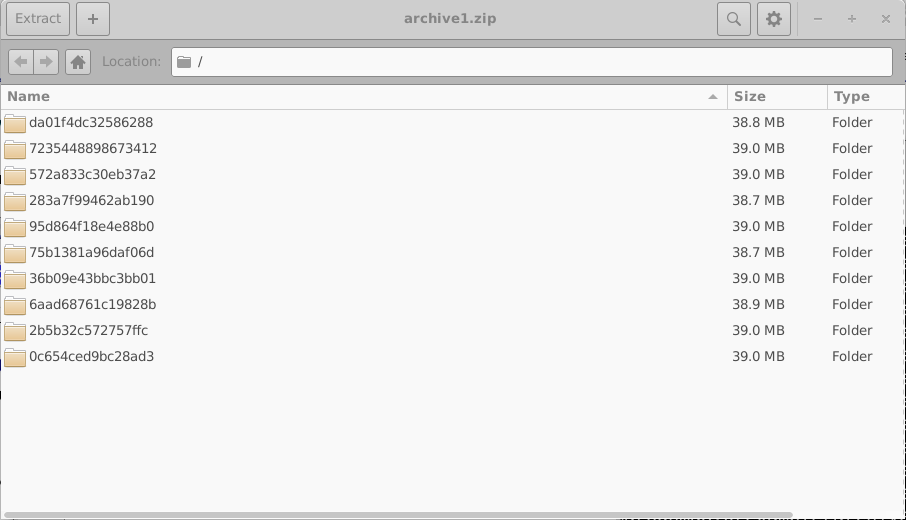
Simülasyon sırasında karşılaşılan tüm hatalar errors.dat dosyasına kaydedilir. archive0.zip dosyasını açmak, bir arşivin iç yapısını gösterir; bu yapı 18.8'in sağ tarafında görülebilir. Her arşiv, her biri tek bir sanal cihaza karşılık gelen bir dizi dizin içerir.Simülasyon sırasında karşılaşılan tüm hatalar errors.dat dosyasına kaydedilir. archive0.zip dosyasını açmak, bir arşivin iç yapısını gösterir; bu yapı 18.8'in sağ tarafında görülebilir. Her arşiv, her biri tek bir sanal cihaza karşılık gelen bir dizi dizin içerir.
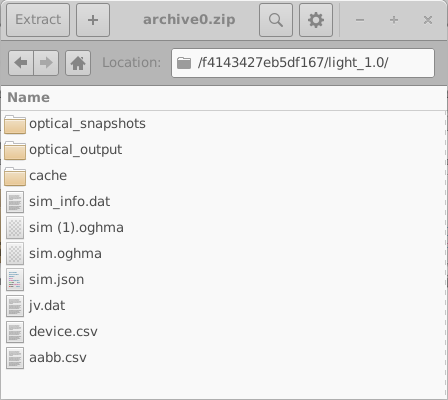
Bu dizinler, rastgele oluşturulmuş 16 basamaklı onaltılık tanımlayıcılar kullanılarak adlandırılır. Her dizin, bir sanal cihaz için gerçekleştirilen tüm simülasyonları içerir; bu örnekte, bir karanlık JV simülasyonu ve dokuz aydınlatılmış JV simülasyonu bulunmaktadır. Bu tür bir dizinin içeriği, 18.10'daki sol tarafta gösterilmiştir. Bireysel bir simülasyon dizininin açılması (18.10, sağ), sim.json dosyası ve simüle edilmiş akım-gerilim özelliklerini içeren jv.dat dosyası da dahil olmak üzere, eksiksiz bir OghmaNano simülasyonunu ortaya çıkarır. Optik çıktılar ve önbellek dosyaları gibi ek veriler de bulunabilir.Bu dizinler, rastgele oluşturulmuş 16 basamaklı onaltılık tanımlayıcılar kullanılarak adlandırılır. Her dizin, bir sanal cihaz için gerçekleştirilen tüm simülasyonları içerir; bu örnekte, bir karanlık JV simülasyonu ve dokuz aydınlatılmış JV simülasyonu bulunmaktadır. Bu tür bir dizinin içeriği, 18.10'daki sol tarafta gösterilmiştir. Bireysel bir simülasyon dizininin açılması (18.10, sağ), sim.json dosyası ve simüle edilmiş akım-gerilim özelliklerini içeren jv.dat dosyası da dahil olmak üzere, eksiksiz bir OghmaNano simülasyonunu ortaya çıkarır. Optik çıktılar ve önbellek dosyaları gibi ek veriler de bulunabilir.
Büyük ölçekli makine öğrenimi veri kümeleri oluşturulurken, gereksiz çıktıların en aza indirilmesi şiddetle tavsiye edilir, çünkü toplam disk kullanımı hızla artabilir. Bu, simülasyonun yalnızca gerekli çıktı verilerini üretmek üzere yapılandırılmasıyla sağlanabilir. Veri kümesi oluşturma işlemi, tüm kullanılabilir CPU çekirdeklerinde paralel olarak yürütülen simülasyonlarla gruplar halinde gerçekleştirilirken, arşiv oluşturma işlemi tek bir çekirdek üzerinde gerçekleştirilir.Büyük ölçekli makine öğrenimi veri kümeleri oluşturulurken, gereksiz çıktıların en aza indirilmesi şiddetle tavsiye edilir, çünkü toplam disk kullanımı hızla artabilir. Bu, simülasyonun yalnızca gerekli çıktı verilerini üretmek üzere yapılandırılmasıyla sağlanabilir. Veri kümesi oluşturma işlemi, tüm kullanılabilir CPU çekirdeklerinde paralel olarak yürütülen simülasyonlarla gruplar halinde gerçekleştirilirken, arşiv oluşturma işlemi tek bir çekirdek üzerinde gerçekleştirilir.
Bu örnekte sadece üç arşiv oluşturulmaktadır. Ancak, normal bir üretim sürecinde genellikle yaklaşık 200 arşiv oluşturulur ve her bir arşivde yaklaşık 200 sanal cihaz bulunur.Bu örnekte sadece üç arşiv oluşturulmaktadır. Ancak, normal bir üretim sürecinde genellikle yaklaşık 200 arşiv oluşturulur ve her bir arşivde yaklaşık 200 sanal cihaz bulunur.
In the above example we only have three archives but in a normal simulation run one would have up to 200 archives each with 200 simulations in each.
7. Elde edilen sonuçları tek bir dosyada toplamak7. Elde edilen sonuçları tek bir dosyada toplamak
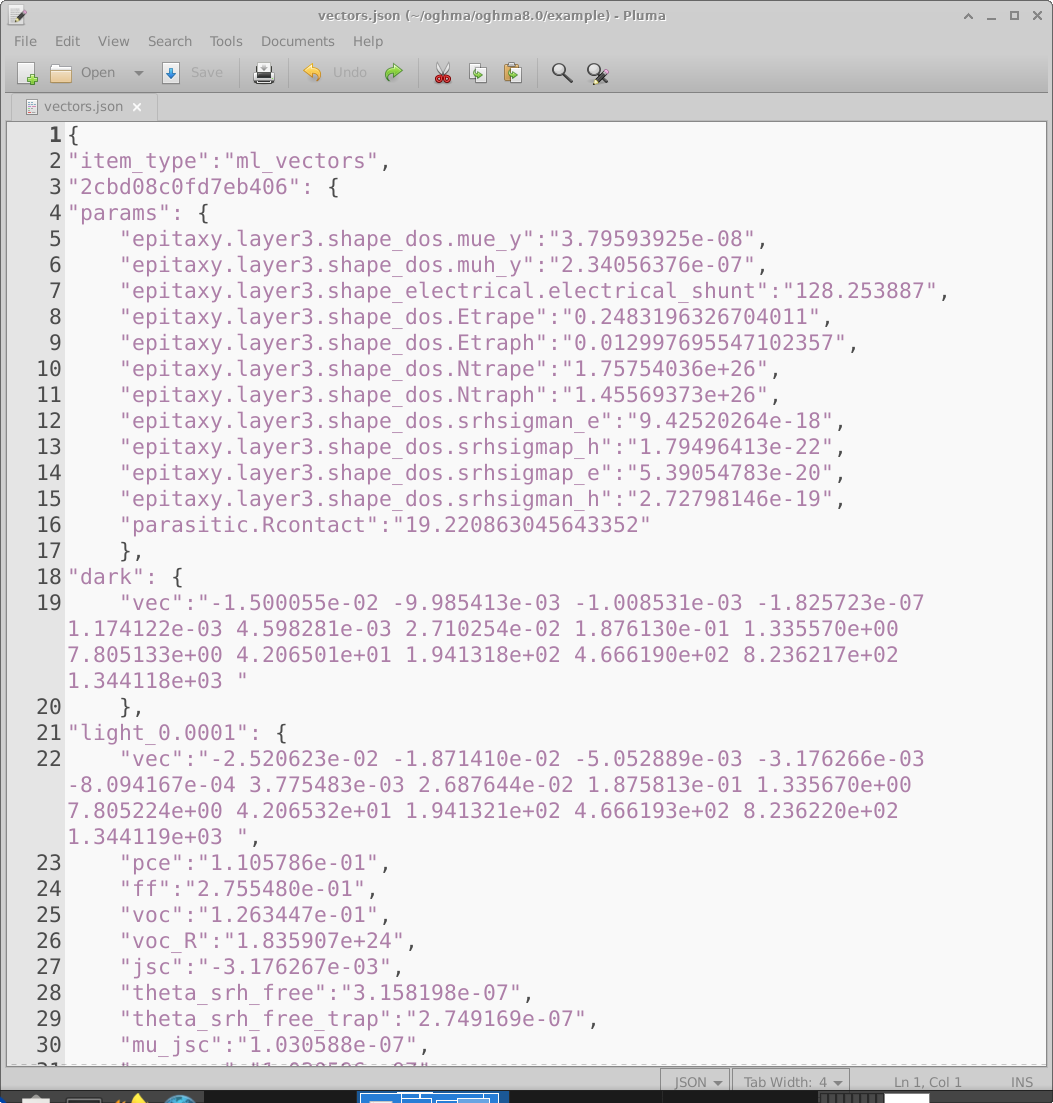
Simülasyonlar tamamlandıktan sonra, ham OghmaNano çıktısı, bir makine öğrenimi modelini eğitmek için uygun tek bir vektör dosyasına dönüştürülmelidir. Ana Makine Öğrenimi penceresindeki "Vektörler Oluştur" simgesine tıklamak (18.2), OghmaNano'nun her sanal cihaz dizinini açmasına, istenen çıktıları çıkarmasına ve bunları tek bir vectors.json dosyası halinde birleştirmesine neden olur. Bu dosyanın bir örneği 18.11'de gösterilmiştir.Simülasyonlar tamamlandıktan sonra, ham OghmaNano çıktısı, bir makine öğrenimi modelini eğitmek için uygun tek bir vektör dosyasına dönüştürülmelidir. Ana Makine Öğrenimi penceresindeki "Vektörler Oluştur" simgesine tıklamak (18.2), OghmaNano'nun her sanal cihaz dizinini açmasına, istenen çıktıları çıkarmasına ve bunları tek bir vectors.json dosyası halinde birleştirmesine neden olur. Bu dosyanın bir örneği 18.11'de gösterilmiştir.
Vektör dosyası, denetimli öğrenme için gerekli tüm bilgileri içeren bir JSON belgesidir. Her sanal cihaz, ayrı bir giriş olarak görünür. Örneğin, 2cbd08c0fd7eb406 olarak etiketlenmiş giriş (satır 3), "params" bölümünde, o sanal cihaz için rastgele seçilmiş elektriksel parametreleri içerir. Bunu, çıkarılan giriş vektörleri izler; örneğin, karanlık JV vektörü (satır 19) ve 0,0001 Güneş'te aydınlatılmış JV vektörü (satır 22). Her vektördeki sayısal birimler, doğrudan çıkarıldıkları kaynak dosyadan alınır. Bu örnekte vektörler, akım yoğunluğunu voltaja bağlı olarak \(A\,m^{-2}\) biriminde saklayan jv.dat dosyasından alınmıştır, bu nedenle vektör değerleri \(A\,m^{-2}\) birimindedir. Giriş vektörlerinden sonra, kolaylık sağlamak amacıyla ek skaler çıktılar (örneğin, PCE) saklanır.Vektör dosyası, denetimli öğrenme için gerekli tüm bilgileri içeren bir JSON belgesidir. Her sanal cihaz, ayrı bir giriş olarak görünür. Örneğin, 2cbd08c0fd7eb406 olarak etiketlenmiş giriş (satır 3), "params" bölümünde, o sanal cihaz için rastgele seçilmiş elektriksel parametreleri içerir. Bunu, çıkarılan giriş vektörleri izler; örneğin, karanlık JV vektörü (satır 19) ve 0,0001 Güneş'te aydınlatılmış JV vektörü (satır 22). Her vektördeki sayısal birimler, doğrudan çıkarıldıkları kaynak dosyadan alınır. Bu örnekte vektörler, akım yoğunluğunu voltaja bağlı olarak \(A\,m^{-2}\) biriminde saklayan jv.dat dosyasından alınmıştır, bu nedenle vektör değerleri \(A\,m^{-2}\) birimindedir. Giriş vektörlerinden sonra, kolaylık sağlamak amacıyla ek skaler çıktılar (örneğin, PCE) saklanır.
Bu dosyada, oluşturulan her sanal cihaz için bir giriş bulunacaktır. vectors.json dosyası oluşturulduktan sonra, seçtiğiniz makine öğrenimi iş akışı için eğitim veri kümesi olarak kullanılabilir. Bazı kullanıcılar, verileri CSV formatına dönüştürdükten sonra TensorFlow'a aktarmayı daha kolay bulmaktadır; bu, standart Python kütüphaneleri kullanılarak yapılabilir.Bu dosyada, oluşturulan her sanal cihaz için bir giriş bulunacaktır. vectors.json dosyası oluşturulduktan sonra, seçtiğiniz makine öğrenimi iş akışı için eğitim veri kümesi olarak kullanılabilir. Bazı kullanıcılar, verileri CSV formatına dönüştürdükten sonra TensorFlow'a aktarmayı daha kolay bulmaktadır; bu, standart Python kütüphaneleri kullanılarak yapılabilir.
8. From data set to machine learning
Önceki bölümler, OghmaNano'nun JSON formatında eksiksiz bir makine öğrenimi veri kümesi oluşturmak için nasıl kullanıldığını açıklamaktadır. Bu aşamada, veri oluşturma süreci tamamlanır: her sanal cihaz için dosya, rastgele seçilen model parametrelerini ve ilgili simülasyon çıktılarını, giriş vektörleri olarak kodlanmış şekilde içerir.Önceki bölümler, OghmaNano'nun JSON formatında eksiksiz bir makine öğrenimi veri kümesi oluşturmak için nasıl kullanıldığını açıklamaktadır. Bu aşamada, veri oluşturma süreci tamamlanır: her sanal cihaz için dosya, rastgele seçilen model parametrelerini ve ilgili simülasyon çıktılarını, giriş vektörleri olarak kodlanmış şekilde içerir.
Bir sonraki adım, bu verileri seçtiğiniz bir makine öğrenimi çerçevesine aktarmaktır. Uygulamada bu genellikle vectors.json dosyasının okunmasını ve CSV gibi tablo biçiminde bir formata dönüştürülmesini içerir; bu format daha sonra eğitim, doğrulama ve test süreçlerinde kullanılabilir. Bu dönüşüm, standart komut dosyası araçları (örneğin, Python) kullanılarak kolayca gerçekleştirilebilir.Bir sonraki adım, bu verileri seçtiğiniz bir makine öğrenimi çerçevesine aktarmaktır. Uygulamada bu genellikle vectors.json dosyasının okunmasını ve CSV gibi tablo biçiminde bir formata dönüştürülmesini içerir; bu format daha sonra eğitim, doğrulama ve test süreçlerinde kullanılabilir. Bu dönüşüm, standart komut dosyası araçları (örneğin, Python) kullanılarak kolayca gerçekleştirilebilir.
Dönüştürüldükten sonra, elde edilen veriler, TensorFlow, PyTorch veya benzeri bir kütüphane kullanılarak uygulanan bir makine öğrenimi çerçevesi aracılığıyla bir sinir ağı veya diğer regresyon modelini eğitmek için kullanılabilir. Bundan sonra, ağ mimarisi, kayıp fonksiyonu ve eğitim stratejisi seçimi, uygulamaya özgü olup OghmaNano'dan bağımsızdır.Dönüştürüldükten sonra, elde edilen veriler, TensorFlow, PyTorch veya benzeri bir kütüphane kullanılarak uygulanan bir makine öğrenimi çerçevesi aracılığıyla bir sinir ağı veya diğer regresyon modelini eğitmek için kullanılabilir. Bundan sonra, ağ mimarisi, kayıp fonksiyonu ve eğitim stratejisi seçimi, uygulamaya özgü olup OghmaNano'dan bağımsızdır.
Bu sayede OghmaNano, fiziksel olarak tutarlı eğitim verileri oluşturmak için eksiksiz ve otomatik bir süreç sunar ve ardından yapılacak makine öğrenimi modeli geliştirme ve optimizasyon işlemlerinin tamamı kullanıcının kontrolünde kalır.Bu sayede OghmaNano, fiziksel olarak tutarlı eğitim verileri oluşturmak için eksiksiz ve otomatik bir süreç sunar ve ardından yapılacak makine öğrenimi modeli geliştirme ve optimizasyon işlemlerinin tamamı kullanıcının kontrolünde kalır.