

Vytváření datových sad pro strojové učeníVytváření datových sad pro strojové učení
Tato kapitola popisuje, jak vytvářet datové sady pro strojové učení pomocí nástroje OghmaNano. Tyto datové sady se obvykle exportují a zpracovávají pomocí externích frameworků, jako je například TensorFlow, a to za účelem trénování, provádění odvozených výpočtů nebo predikcí.Tato kapitola popisuje, jak vytvářet datové sady pro strojové učení pomocí nástroje OghmaNano. Tyto datové sady se obvykle exportují a zpracovávají pomocí externích frameworků, jako je například TensorFlow, a to za účelem trénování, provádění odvozených výpočtů nebo predikcí.
1. Úvod1. Úvod
Často je žádoucí získat fyzikální parametry zařízení z experimentálních dat pomocí modelování. Například, pokud máme k dispozici sadu křivek závislosti proudu na napětí (JV křivky), můžeme chtít určit pohyblivost nosičů náboje a rychlost rekombinace v zařízení. Tradičně se toho dosahuje přizpůsobením fyzikálního modelu, jako je například OghmaNano, datům (jak je popsáno v návodu pro přizpůsobování). Nevýhodou tohoto přístupu je, že přizpůsobení jedné sady dat může být časově náročné a obtížnost se výrazně zvyšuje, pokud je nutné analyzovat více sad dat. Proces přizpůsobování je složitý a obvykle vyžaduje značné odborné znalosti v oblasti numerického modelování a značné množství manuálních zásahů. V důsledku toho se podrobné přizpůsobování parametrů zařízení provádí pouze relativně malou skupinou odborníků.Často je žádoucí získat fyzikální parametry zařízení z experimentálních dat pomocí modelování. Například, pokud máme k dispozici sadu křivek závislosti proudu na napětí (JV křivky), můžeme chtít určit pohyblivost nosičů náboje a rychlost rekombinace v zařízení. Tradičně se toho dosahuje přizpůsobením fyzikálního modelu, jako je například OghmaNano, datům (jak je popsáno v návodu pro přizpůsobování). Nevýhodou tohoto přístupu je, že přizpůsobení jedné sady dat může být časově náročné a obtížnost se výrazně zvyšuje, pokud je nutné analyzovat více sad dat. Proces přizpůsobování je složitý a obvykle vyžaduje značné odborné znalosti v oblasti numerického modelování a značné množství manuálních zásahů. V důsledku toho se podrobné přizpůsobování parametrů zařízení provádí pouze relativně malou skupinou odborníků.
Modernější přístup spočívá v použití strojového učení. Místo přímého přizpůsobení jedné křivky závislosti proudu a napětí (JV) se nejprve vytvoří simulace, která reprezentuje strukturu zařízení. Namísto optimalizace jednotlivých elektrických parametrů se vygeneruje mnoho tisíc kopií tohoto zařízení s náhodně vybranými hodnotami parametrů. Každá z těchto kopií se označuje jako virtuální zařízení. Poté se použije simulační program, jako je OghmaNano, k vygenerování křivek JV pro každé virtuální zařízení, čímž vznikne datový soubor obsahující křivky JV spárované s odpovídajícími elektrickými parametry. Tato data lze použít k trénování modelu strojového učení, který bude přímo předpovídat elektrické parametry na základě charakteristik křivek JV. V tomto rámci funguje OghmaNano jako přímá transformace, která mapuje elektrické parametry na simulovaná experimentální data, zatímco model strojového učení poskytuje inverzní transformaci. Po natrénování lze model použít k získání materiálových parametrů ze skutečných zařízení.Modernější přístup spočívá v použití strojového učení. Místo přímého přizpůsobení jedné křivky závislosti proudu a napětí (JV) se nejprve vytvoří simulace, která reprezentuje strukturu zařízení. Namísto optimalizace jednotlivých elektrických parametrů se vygeneruje mnoho tisíc kopií tohoto zařízení s náhodně vybranými hodnotami parametrů. Každá z těchto kopií se označuje jako virtuální zařízení. Poté se použije simulační program, jako je OghmaNano, k vygenerování křivek JV pro každé virtuální zařízení, čímž vznikne datový soubor obsahující křivky JV spárované s odpovídajícími elektrickými parametry. Tato data lze použít k trénování modelu strojového učení, který bude přímo předpovídat elektrické parametry na základě charakteristik křivek JV. V tomto rámci funguje OghmaNano jako přímá transformace, která mapuje elektrické parametry na simulovaná experimentální data, zatímco model strojového učení poskytuje inverzní transformaci. Po natrénování lze model použít k získání materiálových parametrů ze skutečných zařízení.
Hlavní výhodou tohoto přístupu je, že po provedení tréninku dokáže model strojového učení získat materiálové parametry z experimentálních dat během několika sekund, aniž by uživatel musel být odborníkem v oblasti numerického modelování. Úspěch této metody však závisí na vytvoření rozsáhlé a kvalitní sady tréninkových dat. Postup vytváření takových datových sad pomocí nástroje OghmaNano je popsán v následujících částech.Hlavní výhodou tohoto přístupu je, že po provedení tréninku dokáže model strojového učení získat materiálové parametry z experimentálních dat během několika sekund, aniž by uživatel musel být odborníkem v oblasti numerického modelování. Úspěch této metody však závisí na vytvoření rozsáhlé a kvalitní sady tréninkových dat. Postup vytváření takových datových sad pomocí nástroje OghmaNano je popsán v následujících částech.
2. Otevření ukázkového souboru.2. Otevření ukázkového souboru.
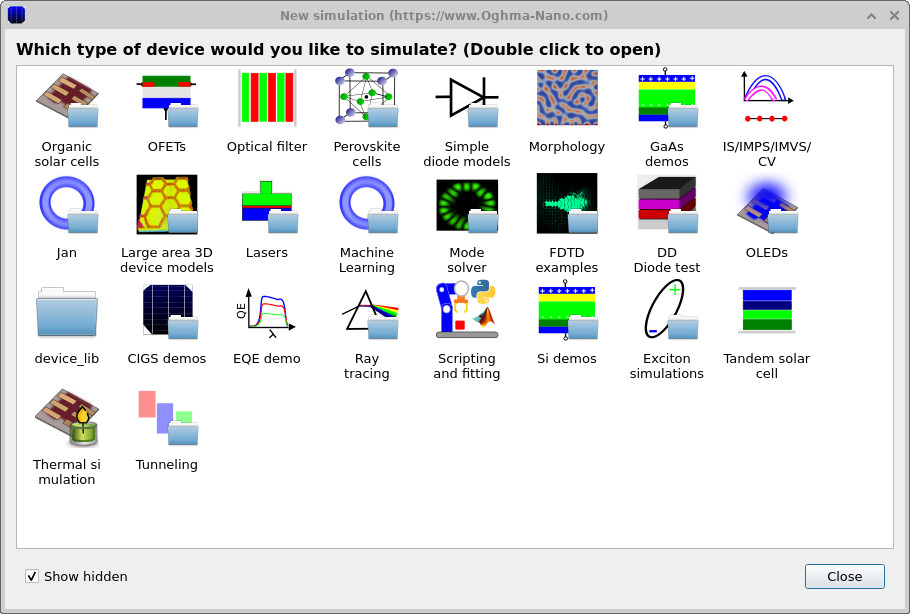
Příklad, o kterém se zde hovoří, lze otevřít pomocí tlačítka „Nová simulace“ v hlavním okně. Tím se otevře prohlížeč „Nová simulace“, který je znázorněn v ??.Příklad, o kterém se zde hovoří, lze otevřít pomocí tlačítka „Nová simulace“ v hlavním okně. Tím se otevře prohlížeč „Nová simulace“, který je znázorněn v ??.
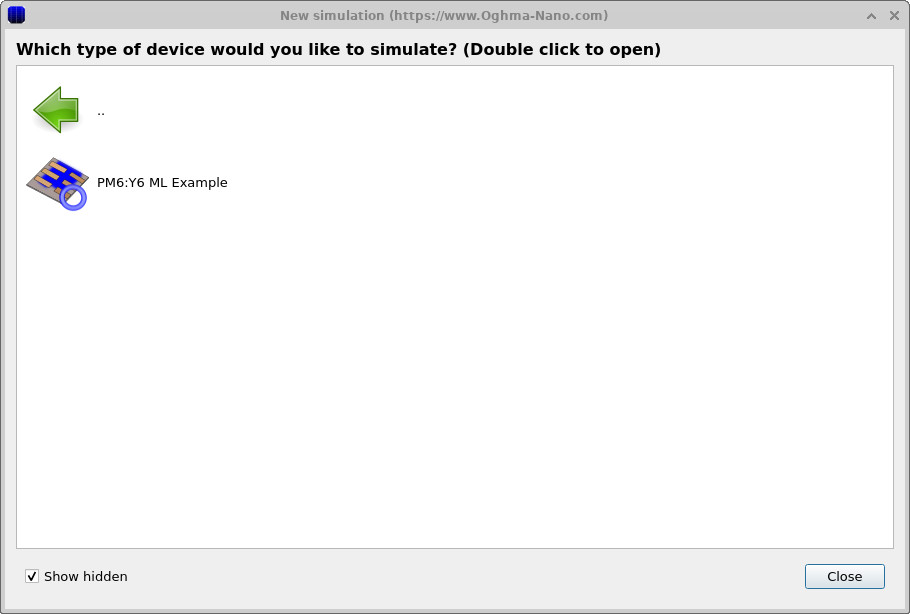
Ze seznamu dostupných kategorií simulací dvakrát klikněte na možnost Strojové učení, čímž se zobrazí příklady strojového učení (??). Vybráním příkladu PM6:Y6 ML se načte předkonfigurovaná simulace, která odpovídá zařízení a pracovnímu postupu popsanému v této kapitole.Ze seznamu dostupných kategorií simulací dvakrát klikněte na možnost Strojové učení, čímž se zobrazí příklady strojového učení (??). Vybráním příkladu PM6:Y6 ML se načte předkonfigurovaná simulace, která odpovídá zařízení a pracovnímu postupu popsanému v této kapitole.
Po spuštění simulace se zobrazí stejná struktura zařízení a nastavení automatizace, které se používají v celé této části, a lze ji přímo využít k generování dat pro trénování modelů strojového učení, aniž by bylo nutné další nastavování.Po spuštění simulace se zobrazí stejná struktura zařízení a nastavení automatizace, které se používají v celé této části, a lze ji přímo využít k generování dat pro trénování modelů strojového učení, aniž by bylo nutné další nastavování.
3. Definování simulací a výstupních vektorů.3. Definování simulací a výstupních vektorů.
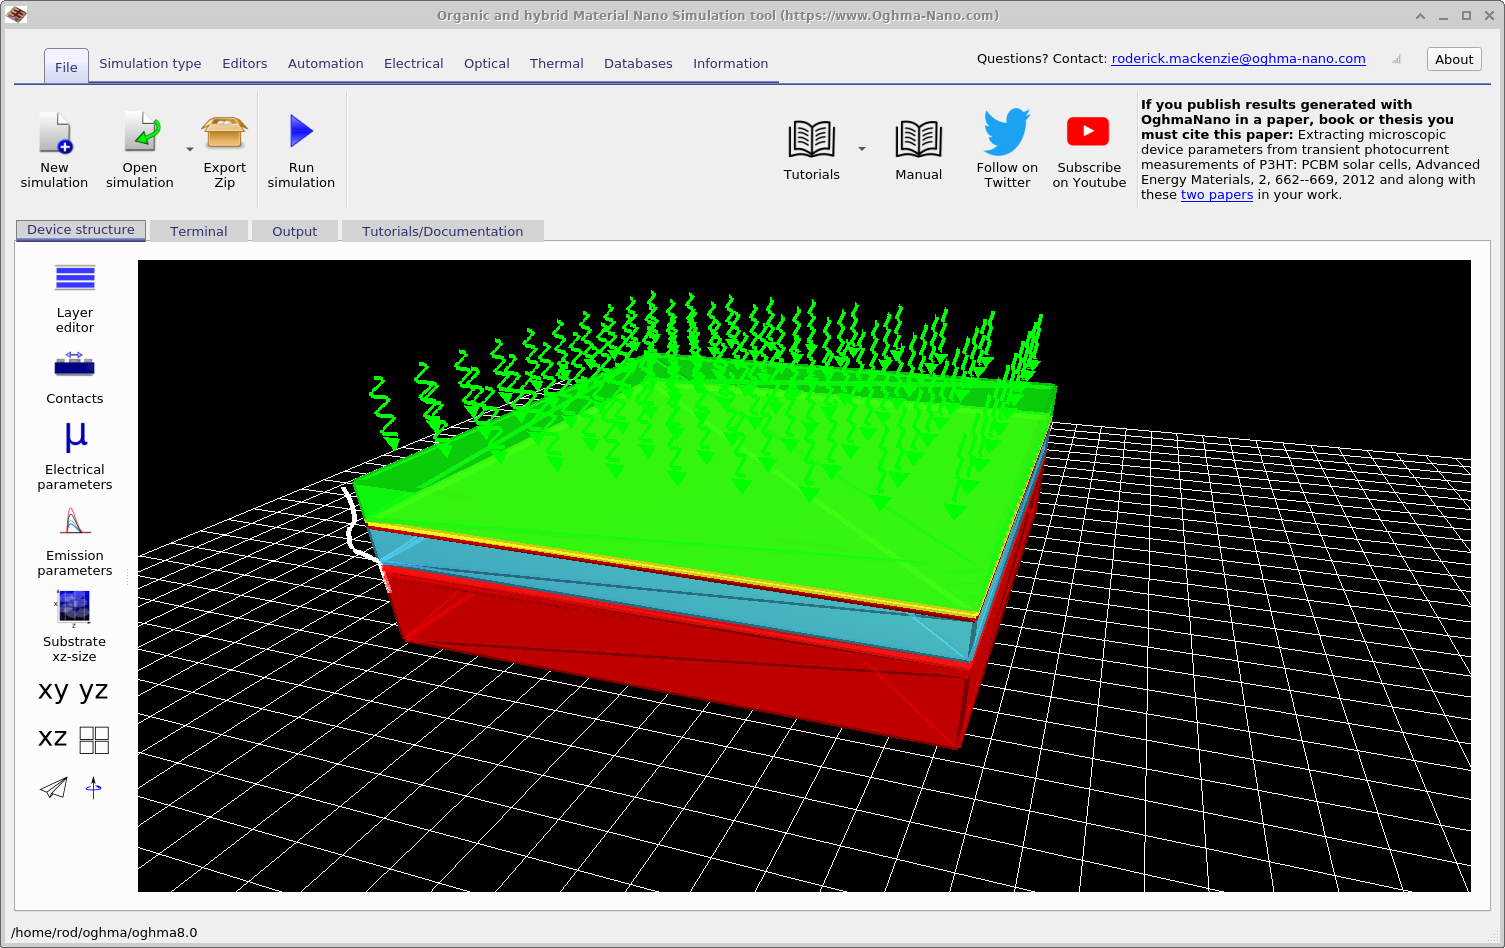
Jakmile se otevře ukázková simulace, zobrazí se hlavní okno simulace, které je znázorněno na obrázku ??. Toto okno zobrazuje plně nakonfigurovanou strukturu zařízení, která se používá v celé této kapitole. Na kartě Automatizace je vidět ikona Strojové učení, která je reprezentována modrým kruhovým symbolem. Kliknutím na tuto ikonu se otevře hlavní ovládací okno pro strojové učení, které je znázorněno na obrázku ??. Z tohoto okna se konfiguruje a spouští generování trénovacích dat pro strojové učení.Jakmile se otevře ukázková simulace, zobrazí se hlavní okno simulace, které je znázorněno na obrázku ??. Toto okno zobrazuje plně nakonfigurovanou strukturu zařízení, která se používá v celé této kapitole. Na kartě Automatizace je vidět ikona Strojové učení, která je reprezentována modrým kruhovým symbolem. Kliknutím na tuto ikonu se otevře hlavní ovládací okno pro strojové učení, které je znázorněno na obrázku ??. Z tohoto okna se konfiguruje a spouští generování trénovacích dat pro strojové učení.
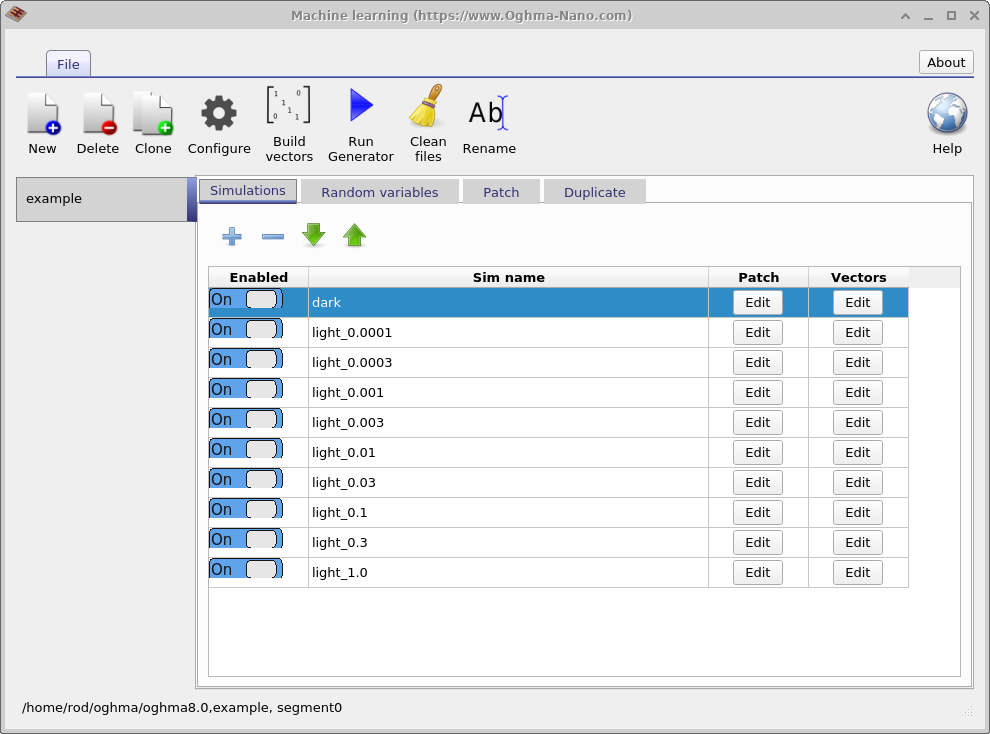
Hlavním účelem tohoto okna je generovat rozsáhlé datové soubory pro trénování algoritmů strojového učení. Datový soubor vytvořený v tomto příkladu se nazývá „example“. První zobrazená záložka je záložka „Simulace“, která definuje sadu simulací prováděných pro každé virtuální zařízení. V tomto případě jsou simulovány tmavá křivka JV a devět osvětlených křivek JV, přičemž intenzita světla se pohybuje od 0,0001 Slunce do 1,0 Slunce. Jednotlivé simulace lze zapnout nebo vypnout pomocí přepínače „Povoleno“. Pokud se klikne na tlačítko „Upravit“ ve sloupci „Patch“ u položky \(light\_0.0001\), otevře se okno „Patch“ zobrazené v ??.Hlavním účelem tohoto okna je generovat rozsáhlé datové soubory pro trénování algoritmů strojového učení. Datový soubor vytvořený v tomto příkladu se nazývá „example“. První zobrazená záložka je záložka „Simulace“, která definuje sadu simulací prováděných pro každé virtuální zařízení. V tomto případě jsou simulovány tmavá křivka JV a devět osvětlených křivek JV, přičemž intenzita světla se pohybuje od 0,0001 Slunce do 1,0 Slunce. Jednotlivé simulace lze zapnout nebo vypnout pomocí přepínače „Povoleno“. Pokud se klikne na tlačítko „Upravit“ ve sloupci „Patch“ u položky \(light\_0.0001\), otevře se okno „Patch“ zobrazené v ??.
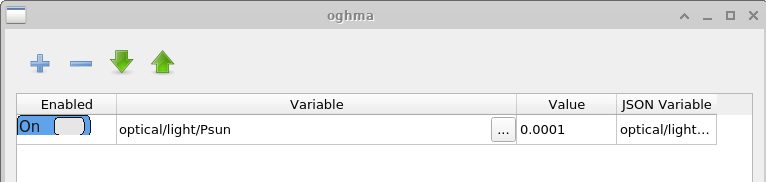
Účelem okna Patch je upravovat parametry v rámci virtuální simulace. V tomto příkladu je generováno několik křivek JV (proud-napětí) za různých podmínek osvětlení, přičemž je použita stejná základní struktura zařízení. K dosažení tohoto cíle je nutné nezávisle upravit intenzitu světla pro každou simulaci. Otevření okna Patch pro \(light\_0.0001\) ukazuje, že parametr simulace optical/light/Psun, který řídí intenzitu osvětlení, je nastaven na \(0.0001\). Pro simulaci v temnotě je stejný parametr nastaven na \(0.0\). Tímto způsobem lze konzistentně simulovat několik experimentálních podmínek pomocí jedné základní simulace.Účelem okna Patch je upravovat parametry v rámci virtuální simulace. V tomto příkladu je generováno několik křivek JV (proud-napětí) za různých podmínek osvětlení, přičemž je použita stejná základní struktura zařízení. K dosažení tohoto cíle je nutné nezávisle upravit intenzitu světla pro každou simulaci. Otevření okna Patch pro \(light\_0.0001\) ukazuje, že parametr simulace optical/light/Psun, který řídí intenzitu osvětlení, je nastaven na \(0.0001\). Pro simulaci v temnotě je stejný parametr nastaven na \(0.0\). Tímto způsobem lze konzistentně simulovat několik experimentálních podmínek pomocí jedné základní simulace.
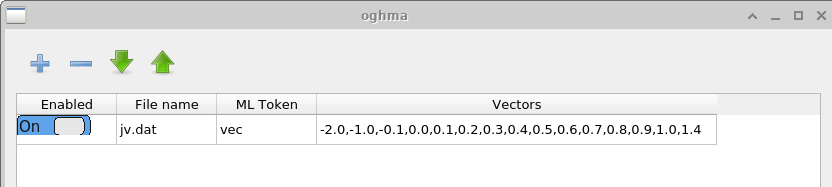
Okno „Vektory“ definuje, která data se extrahují z dokončených simulací, aby se vytvořily vstupní vektory pro strojové učení. V tomto příkladu se z souboru \(jv.dat\), který obsahuje simulované charakteristiky závislosti proudu na napětí, extrahují datové body v rozsahu od –2,0 V do 1,4 V. U simulací v časové oblasti může uživatel místo toho extrahovat data ze souborů, jako je \(time\_i.csv\), nebo z jiného vhodného výstupního souboru. Počet bodů použitých pro vytvoření každého vstupního vektoru volí uživatel. Delší vektory zvyšují výpočetní náročnost trénování, ale mohou zachytit podrobnější rysy křivky závislosti proudu na napětí.Okno „Vektory“ definuje, která data se extrahují z dokončených simulací, aby se vytvořily vstupní vektory pro strojové učení. V tomto příkladu se z souboru \(jv.dat\), který obsahuje simulované charakteristiky závislosti proudu na napětí, extrahují datové body v rozsahu od –2,0 V do 1,4 V. U simulací v časové oblasti může uživatel místo toho extrahovat data ze souborů, jako je \(time\_i.csv\), nebo z jiného vhodného výstupního souboru. Počet bodů použitých pro vytvoření každého vstupního vektoru volí uživatel. Delší vektory zvyšují výpočetní náročnost trénování, ale mohou zachytit podrobnější rysy křivky závislosti proudu na napětí.
4. Definování náhodných proměnných4. Definování náhodných proměnných
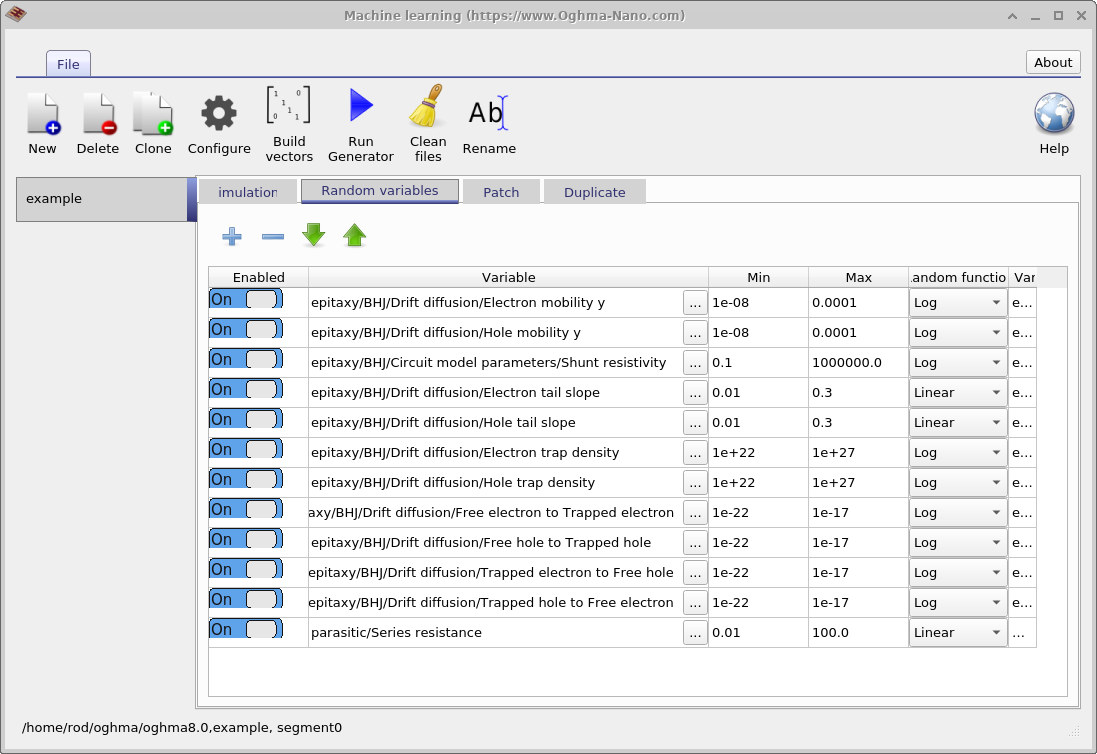
Dalším krokem je definovat, které parametry modelu budou náhodně generovány. To se provádí pomocí záložky „Náhodné proměnné“ v hlavním okně pro strojové učení. Tabulka obsahuje pět sloupců. Sloupec „Aktivní“ určuje, zda je daný parametr zahrnut do procesu náhodné generace. Sloupec „Proměnná“ specifikuje, který parametr simulace se bude měnit. Sloupce „Min“ a „Max“ definují dolní a horní hranici rozsahu parametrů a sloupec „Náhodná funkce“ určuje, zda se hodnoty generují z lineárního nebo logaritmického rozdělení.Dalším krokem je definovat, které parametry modelu budou náhodně generovány. To se provádí pomocí záložky „Náhodné proměnné“ v hlavním okně pro strojové učení. Tabulka obsahuje pět sloupců. Sloupec „Aktivní“ určuje, zda je daný parametr zahrnut do procesu náhodné generace. Sloupec „Proměnná“ specifikuje, který parametr simulace se bude měnit. Sloupce „Min“ a „Max“ definují dolní a horní hranici rozsahu parametrů a sloupec „Náhodná funkce“ určuje, zda se hodnoty generují z lineárního nebo logaritmického rozdělení.
Pro parametry, které se mění v širokém rozsahu, se doporučují logaritmická rozdělení, zatímco lineární rozdělení jsou vhodná pro parametry, které se mění v relativně úzkém rozsahu. Použití logaritmického rozdělení zajišťuje, že hodnoty jsou při zobrazení na logaritmické stupnici vzorkovány rovnoměrně, a nikoli shlukovány směrem k hornímu konci rozsahu. Například vhodným lineárním parametrem by byla Urbachova energie, která se obvykle pohybuje mezi 30 a 150 meV. Naproti tomu hustoty pastí jsou dobře vhodné pro logaritmické vzorkování, protože se mohou měnit od \(1 \times 10^{15}\,\mathrm{m^{-3}}\) do \(1 \times 10^{25}\,\mathrm{m^{-3}}\).Pro parametry, které se mění v širokém rozsahu, se doporučují logaritmická rozdělení, zatímco lineární rozdělení jsou vhodná pro parametry, které se mění v relativně úzkém rozsahu. Použití logaritmického rozdělení zajišťuje, že hodnoty jsou při zobrazení na logaritmické stupnici vzorkovány rovnoměrně, a nikoli shlukovány směrem k hornímu konci rozsahu. Například vhodným lineárním parametrem by byla Urbachova energie, která se obvykle pohybuje mezi 30 a 150 meV. Naproti tomu hustoty pastí jsou dobře vhodné pro logaritmické vzorkování, protože se mohou měnit od \(1 \times 10^{15}\,\mathrm{m^{-3}}\) do \(1 \times 10^{25}\,\mathrm{m^{-3}}\).
5. Stanovení počtu simulací5. Stanovení počtu simulací
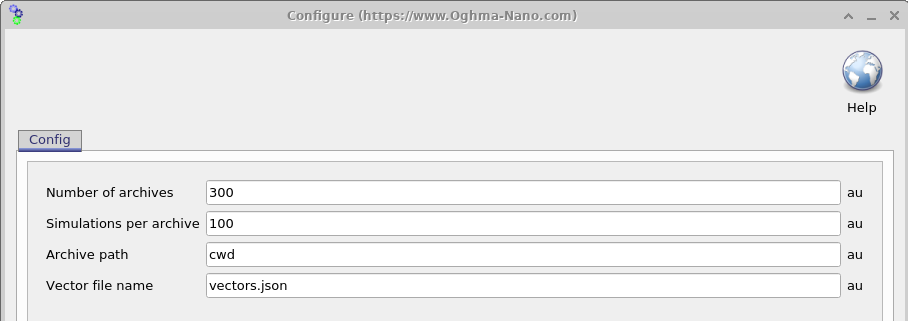
Jakmile je simulace nakonfigurována, dalším krokem je určit, kolik virtuálních zařízení s náhodně generovanými parametry má být vytvořeno. Otevření okna Nastavení (viz 18.6) umožňuje toto nastavení ovládat pomocí dvou parametrů: Počet simulací v archivu (\(N_{\mathrm{sim}}\)) a Počet archivů (\(N_{\mathrm{arc}}\)). Celkový počet vytvořených virtuálních zařízení je uveden v \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\).Jakmile je simulace nakonfigurována, dalším krokem je určit, kolik virtuálních zařízení s náhodně generovanými parametry má být vytvořeno. Otevření okna Nastavení (viz 18.6) umožňuje toto nastavení ovládat pomocí dvou parametrů: Počet simulací v archivu (\(N_{\mathrm{sim}}\)) a Počet archivů (\(N_{\mathrm{arc}}\)). Celkový počet vytvořených virtuálních zařízení je uveden v \(N_{\mathrm{sim}} \times N_{\mathrm{arc}}\).
Výsledky simulace jsou ukládány do souborů ve formátu ZIP, které se označují jako archivy. Každý archiv obsahuje \(N_{\mathrm{sim}}\) virtuálních zařízení. V uvedeném příkladu je generováno a uloženo \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) virtuálních zařízení do 100 archivních souborů. Je důležité poznamenat, že v tomto příkladu se každé virtuální zařízení skládá z jedné simulace „dark JV“ a devíti simulací „illuminated JV“. V důsledku toho se může celkový počet výstupních souborů rychle zvyšovat.Výsledky simulace jsou ukládány do souborů ve formátu ZIP, které se označují jako archivy. Každý archiv obsahuje \(N_{\mathrm{sim}}\) virtuálních zařízení. V uvedeném příkladu je generováno a uloženo \(N_{\mathrm{sim}} \times N_{\mathrm{arc}} = 3000\) virtuálních zařízení do 100 archivních souborů. Je důležité poznamenat, že v tomto příkladu se každé virtuální zařízení skládá z jedné simulace „dark JV“ a devíti simulací „illuminated JV“. V důsledku toho se může celkový počet výstupních souborů rychle zvyšovat.
Pro zajištění efektivního řešení se generování dat provádí v dávkách. Skupina \(N_{\mathrm{sim}}\) simulací je generována a spouštěna programem OghmaNano, poté je uložena do jednoho archivu a tento proces se opakuje, dokud nevznikne \(N_{\mathrm{arc}}\) archivů. Tento přístup omezuje ztrátu dat na aktuálně generovaný archiv v případě přerušení procesu a také zjednodušuje přenos souborů a zvyšuje odolnost proti poškození. Spouštění simulací probíhá paralelně na všech dostupných procesorových jádrech, zatímco vytváření archivů probíhá na jednom jádru.Pro zajištění efektivního řešení se generování dat provádí v dávkách. Skupina \(N_{\mathrm{sim}}\) simulací je generována a spouštěna programem OghmaNano, poté je uložena do jednoho archivu a tento proces se opakuje, dokud nevznikne \(N_{\mathrm{arc}}\) archivů. Tento přístup omezuje ztrátu dat na aktuálně generovaný archiv v případě přerušení procesu a také zjednodušuje přenos souborů a zvyšuje odolnost proti poškození. Spouštění simulací probíhá paralelně na všech dostupných procesorových jádrech, zatímco vytváření archivů probíhá na jednom jádru.
6. Spuštění generátoru datové sady.6. Spuštění generátoru datové sady.
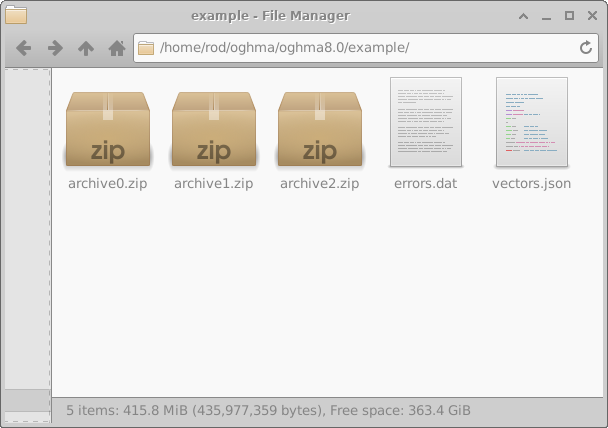
Jakmile je konfigurace dokončena, stisknutím tlačítka „Spustit generátor“ v hlavním okně pro strojové učení (18.2) se spustí proces generování datové sady. Následně OghmaNano začne provádět simulace definované pro každé virtuální zařízení. Po dokončení procesu se v adresáři simulací objeví složka s názvem „example“, jak je znázorněno v levé části obrázku 18.8. Pro účely tohoto příkladu byla hodnota „Počet simulací na archiv“ nastavena na 10 a hodnota „Počet archivů“ na 3, aby se zkrátila doba provádění.Jakmile je konfigurace dokončena, stisknutím tlačítka „Spustit generátor“ v hlavním okně pro strojové učení (18.2) se spustí proces generování datové sady. Následně OghmaNano začne provádět simulace definované pro každé virtuální zařízení. Po dokončení procesu se v adresáři simulací objeví složka s názvem „example“, jak je znázorněno v levé části obrázku 18.8. Pro účely tohoto příkladu byla hodnota „Počet simulací na archiv“ nastavena na 10 a hodnota „Počet archivů“ na 3, aby se zkrátila doba provádění.
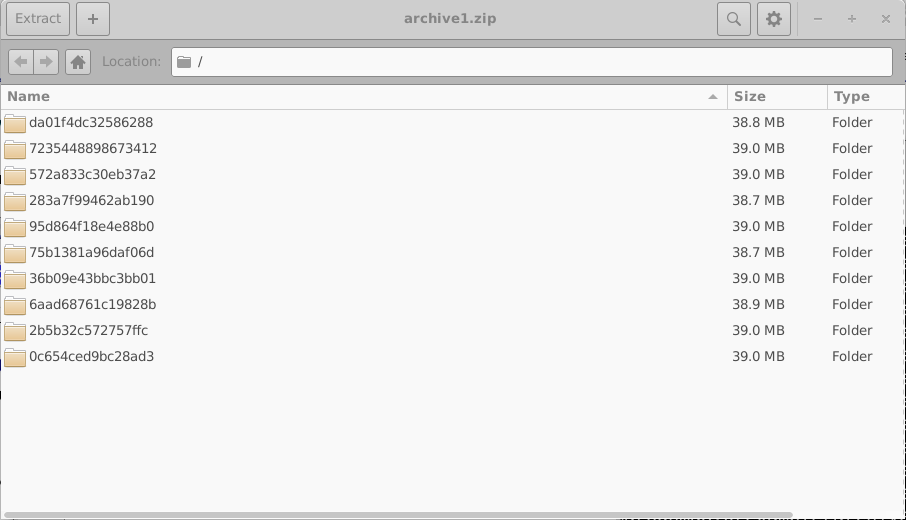
Všechny chyby, které se vyskytnou během simulace, jsou zaznamenávány do souboru errors.dat. Otevřením souboru archive0.zip se zobrazí vnitřní struktura archivu, která je znázorněna na pravé straně obrázku 18.8. Každý archiv obsahuje sadu adresářů, z nichž každý odpovídá jednomu virtuálnímu zařízení.Všechny chyby, které se vyskytnou během simulace, jsou zaznamenávány do souboru errors.dat. Otevřením souboru archive0.zip se zobrazí vnitřní struktura archivu, která je znázorněna na pravé straně obrázku 18.8. Každý archiv obsahuje sadu adresářů, z nichž každý odpovídá jednomu virtuálnímu zařízení.
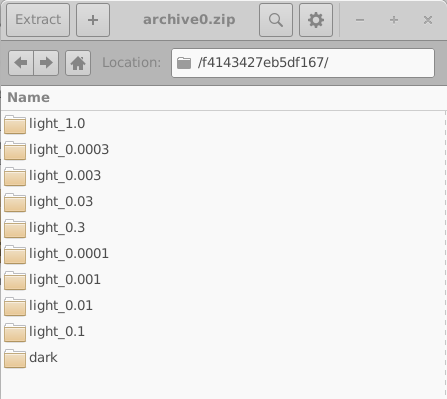
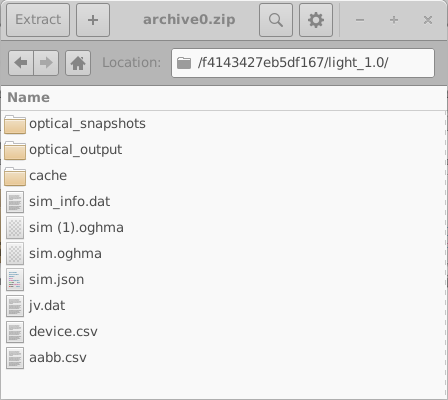
Tyto adresáře jsou pojmenovány pomocí náhodných šestnáctimístných hexadecimálních identifikátorů. Každý adresář obsahuje kompletní sadu simulací pro jedno virtuální zařízení; v tomto příkladu se jedná o jednu simulaci „dark JV“ a devět simulací „illuminated JV“. Obsah jednoho z těchto adresářů je znázorněn v levé části obrázku 18.10. Otevřením jednotlivého adresáře se simulacemi (18.10, vpravo) se zobrazí kompletní simulace OghmaNano, včetně souboru sim.json a souboru jv.dat, který obsahuje simulované charakteristiky závislosti proudu na napětí. Mohou zde být také další data, jako jsou optické výstupy a soubory mezipaměti.Tyto adresáře jsou pojmenovány pomocí náhodných šestnáctimístných hexadecimálních identifikátorů. Každý adresář obsahuje kompletní sadu simulací pro jedno virtuální zařízení; v tomto příkladu se jedná o jednu simulaci „dark JV“ a devět simulací „illuminated JV“. Obsah jednoho z těchto adresářů je znázorněn v levé části obrázku 18.10. Otevřením jednotlivého adresáře se simulacemi (18.10, vpravo) se zobrazí kompletní simulace OghmaNano, včetně souboru sim.json a souboru jv.dat, který obsahuje simulované charakteristiky závislosti proudu na napětí. Mohou zde být také další data, jako jsou optické výstupy a soubory mezipaměti.
Při vytváření rozsáhlých datových sad pro strojové učení se důrazně doporučuje minimalizovat zbytečný výstup, protože celková spotřeba diskového prostoru může rychle narůstat. Toho lze dosáhnout konfigurací simulace tak, aby generovala pouze nezbytná výstupní data. Generování datových sad probíhá v dávkách, přičemž simulace jsou spouštěny paralelně na všech dostupných procesorových jádrech, zatímco vytváření archivů probíhá na jednom jádru.Při vytváření rozsáhlých datových sad pro strojové učení se důrazně doporučuje minimalizovat zbytečný výstup, protože celková spotřeba diskového prostoru může rychle narůstat. Toho lze dosáhnout konfigurací simulace tak, aby generovala pouze nezbytná výstupní data. Generování datových sad probíhá v dávkách, přičemž simulace jsou spouštěny paralelně na všech dostupných procesorových jádrech, zatímco vytváření archivů probíhá na jednom jádru.
V tomto názorném příkladu vznikají pouze tři archivy. Během typické produkční série se však obvykle vytváří přibližně 200 archivů, z nichž každý obsahuje zhruba 200 virtuálních zařízení.V tomto názorném příkladu vznikají pouze tři archivy. Během typické produkční série se však obvykle vytváří přibližně 200 archivů, z nichž každý obsahuje zhruba 200 virtuálních zařízení.
In the above example we only have three archives but in a normal simulation run one would have up to 200 archives each with 200 simulations in each.
7. Sestavení výsledků do jednoho souboru.7. Sestavení výsledků do jednoho souboru.
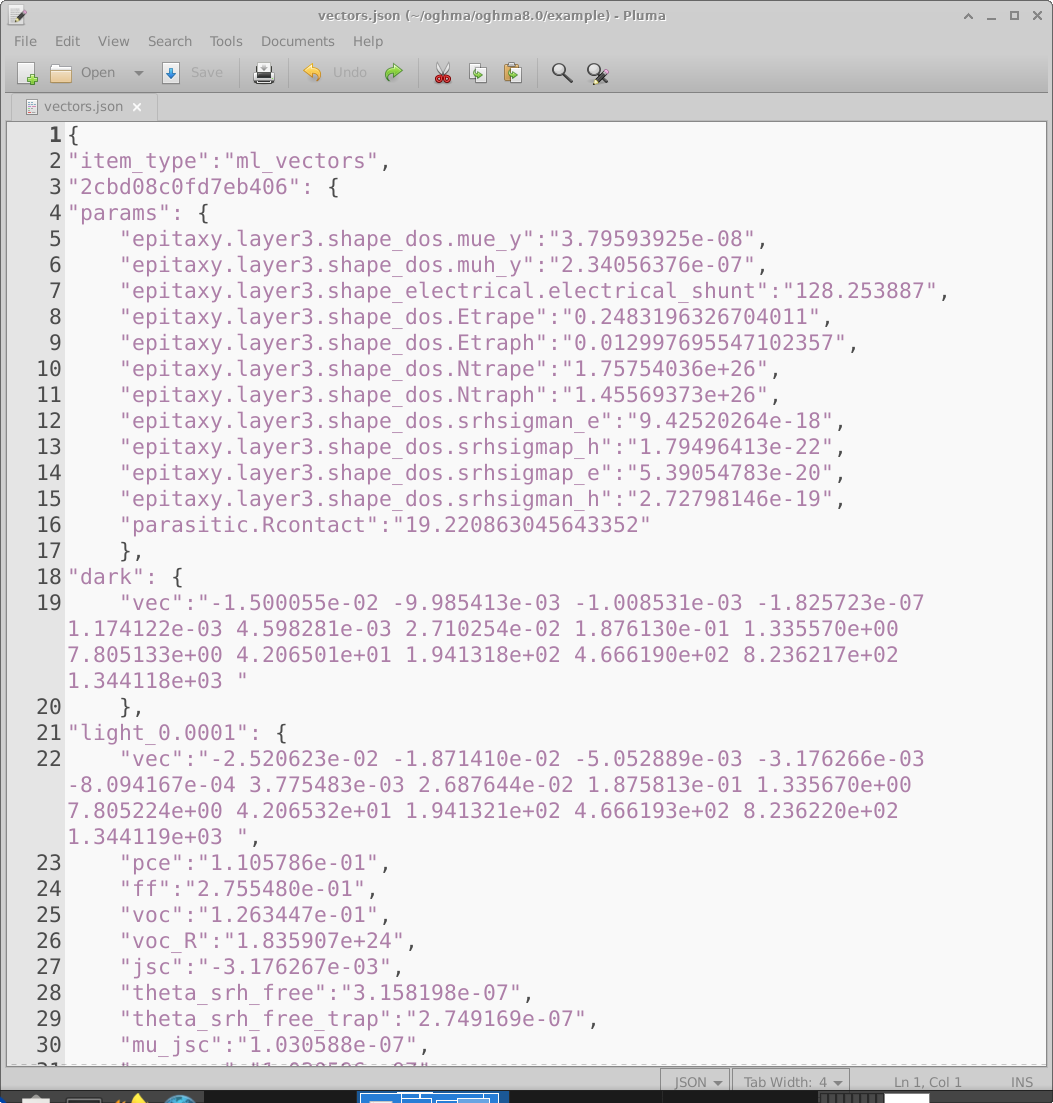
Po dokončení simulací je nutné zpracovat surová data získaná z OghmaNano a převést je do jediného souboru s vektory, který bude vhodný pro trénování modelu strojového učení. Kliknutím na ikonu „Vytvořit vektory“ v hlavním okně strojového učení (18.2) se OghmaNano otevře v každém virtuálním adresáři zařízení, extrahuje požadovaná data a sestaví je do jediného souboru vectors.json. Příklad tohoto souboru je uveden v 18.11.Po dokončení simulací je nutné zpracovat surová data získaná z OghmaNano a převést je do jediného souboru s vektory, který bude vhodný pro trénování modelu strojového učení. Kliknutím na ikonu „Vytvořit vektory“ v hlavním okně strojového učení (18.2) se OghmaNano otevře v každém virtuálním adresáři zařízení, extrahuje požadovaná data a sestaví je do jediného souboru vectors.json. Příklad tohoto souboru je uveden v 18.11.
Soubor vektorů je dokument ve formátu JSON, který obsahuje všechny informace potřebné pro učení s učitelem. Každé virtuální zařízení je reprezentováno jako samostatný záznam. Například záznam označený 2cbd08c0fd7eb406 (řádek 3) obsahuje v sekci „params“ elektrické parametry, které byly náhodně vybrány pro dané virtuální zařízení. Následují extrahované vstupní vektory, jako například vektor temné charakteristiky JV (řádek 19) a vektor charakteristiky JV při osvětlení 0,0001 Suns (řádek 22). Číselné jednotky v každém vektoru jsou přejímány přímo ze zdrojového souboru, ze kterého byly vektory extrahovány. V tomto příkladu jsou vektory získávány ze souboru jv.dat, který ukládá hustotu proudu \(A\,m^{-2}\) jako funkci napětí, takže hodnoty vektoru jsou v jednotkách \(A\,m^{-2}\). Po vstupních vektorech jsou pro usnadnění uloženy další skalární výstupy (například PCE).Soubor vektorů je dokument ve formátu JSON, který obsahuje všechny informace potřebné pro učení s učitelem. Každé virtuální zařízení je reprezentováno jako samostatný záznam. Například záznam označený 2cbd08c0fd7eb406 (řádek 3) obsahuje v sekci „params“ elektrické parametry, které byly náhodně vybrány pro dané virtuální zařízení. Následují extrahované vstupní vektory, jako například vektor temné charakteristiky JV (řádek 19) a vektor charakteristiky JV při osvětlení 0,0001 Suns (řádek 22). Číselné jednotky v každém vektoru jsou přejímány přímo ze zdrojového souboru, ze kterého byly vektory extrahovány. V tomto příkladu jsou vektory získávány ze souboru jv.dat, který ukládá hustotu proudu \(A\,m^{-2}\) jako funkci napětí, takže hodnoty vektoru jsou v jednotkách \(A\,m^{-2}\). Po vstupních vektorech jsou pro usnadnění uloženy další skalární výstupy (například PCE).
V tomto souboru bude pro každý vytvořený virtuální přístroj zaznamenán jeden záznam. Jakmile bude soubor vectors.json vytvořen, lze jej použít jako trénovací datovou sadu pro zvolený pracovní postup strojového učení. Někteří uživatelé zjistili, že je pro ně snazší importovat data do TensorFlow poté, co je převedou do formátu CSV; to lze provést pomocí standardních knihoven Pythonu.V tomto souboru bude pro každý vytvořený virtuální přístroj zaznamenán jeden záznam. Jakmile bude soubor vectors.json vytvořen, lze jej použít jako trénovací datovou sadu pro zvolený pracovní postup strojového učení. Někteří uživatelé zjistili, že je pro ně snazší importovat data do TensorFlow poté, co je převedou do formátu CSV; to lze provést pomocí standardních knihoven Pythonu.
8. From data set to machine learning
Předchozí části popisují, jak se OghmaNano používá k vytvoření kompletního souboru dat pro strojové učení ve formátu JSON. V tomto okamžiku je proces generování dat dokončen: pro každé virtuální zařízení obsahuje soubor náhodně vybrané parametry modelu spolu s odpovídajícími výstupy simulace, které jsou zakódovány jako vstupní vektory.Předchozí části popisují, jak se OghmaNano používá k vytvoření kompletního souboru dat pro strojové učení ve formátu JSON. V tomto okamžiku je proces generování dat dokončen: pro každé virtuální zařízení obsahuje soubor náhodně vybrané parametry modelu spolu s odpovídajícími výstupy simulace, které jsou zakódovány jako vstupní vektory.
Dalším krokem je importovat tato data do vybraného rámce pro strojové učení. V praxi to obvykle zahrnuje načtení souboru vectors.json a jeho převedení do tabulkového formátu, jako je například CSV, který lze následně použít pro trénování, ověřování a testování. Tato konverze může být provedena jednoduše pomocí standardních skriptovacích nástrojů (například Python).Dalším krokem je importovat tato data do vybraného rámce pro strojové učení. V praxi to obvykle zahrnuje načtení souboru vectors.json a jeho převedení do tabulkového formátu, jako je například CSV, který lze následně použít pro trénování, ověřování a testování. Tato konverze může být provedena jednoduše pomocí standardních skriptovacích nástrojů (například Python).
Po převedení lze data použít k trénování neuronové sítě nebo jiného regresního modelu, který je implementován pomocí rámce pro strojové učení, jako je například TensorFlow, PyTorch, nebo podobná knihovna. Od tohoto okamžiku závisí volba architektury sítě, ztrátové funkce a strategie trénování na konkrétní aplikaci a je nezávislá na OghmaNano.Po převedení lze data použít k trénování neuronové sítě nebo jiného regresního modelu, který je implementován pomocí rámce pro strojové učení, jako je například TensorFlow, PyTorch, nebo podobná knihovna. Od tohoto okamžiku závisí volba architektury sítě, ztrátové funkce a strategie trénování na konkrétní aplikaci a je nezávislá na OghmaNano.
Tímto způsobem společnost OghmaNano poskytuje kompletní a automatizovaný proces pro generování fyzicky konzistentních trénovacích dat, přičemž veškerý další vývoj a optimalizace modelu strojového učení ponechává plně v rukou uživatele.Tímto způsobem společnost OghmaNano poskytuje kompletní a automatizovaný proces pro generování fyzicky konzistentních trénovacích dat, přičemž veškerý další vývoj a optimalizace modelu strojového učení ponechává plně v rukou uživatele.